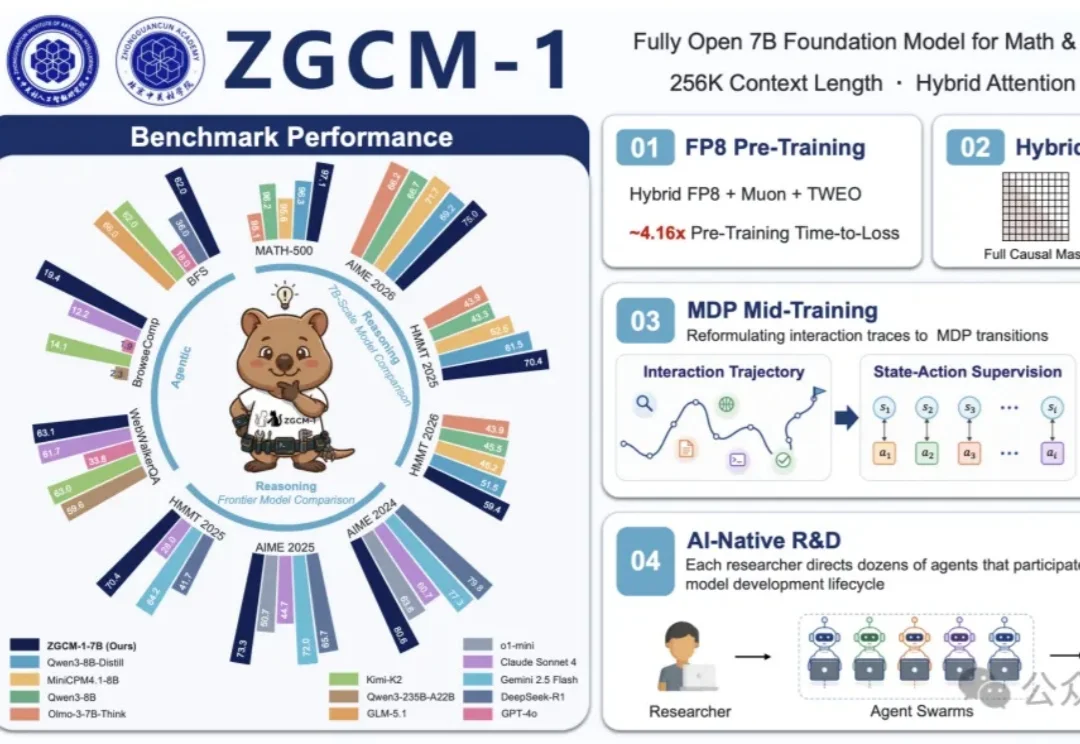
7名博士生仅用3个月从零训练7B大模型:代码+数据+训练日志全公开
7名博士生仅用3个月从零训练7B大模型:代码+数据+训练日志全公开北京中关村学院7名博士生,用一个暑假,从零训练出了一个7B大模型——ZGCM-1。
来自主题: AI资讯
9193 点击 2026-09-15 10:16

 搜索
北京中关村学院7名博士生,用一个暑假,从零训练出了一个7B大模型——ZGCM-1。
视觉编程成绩超GPT-5.4。
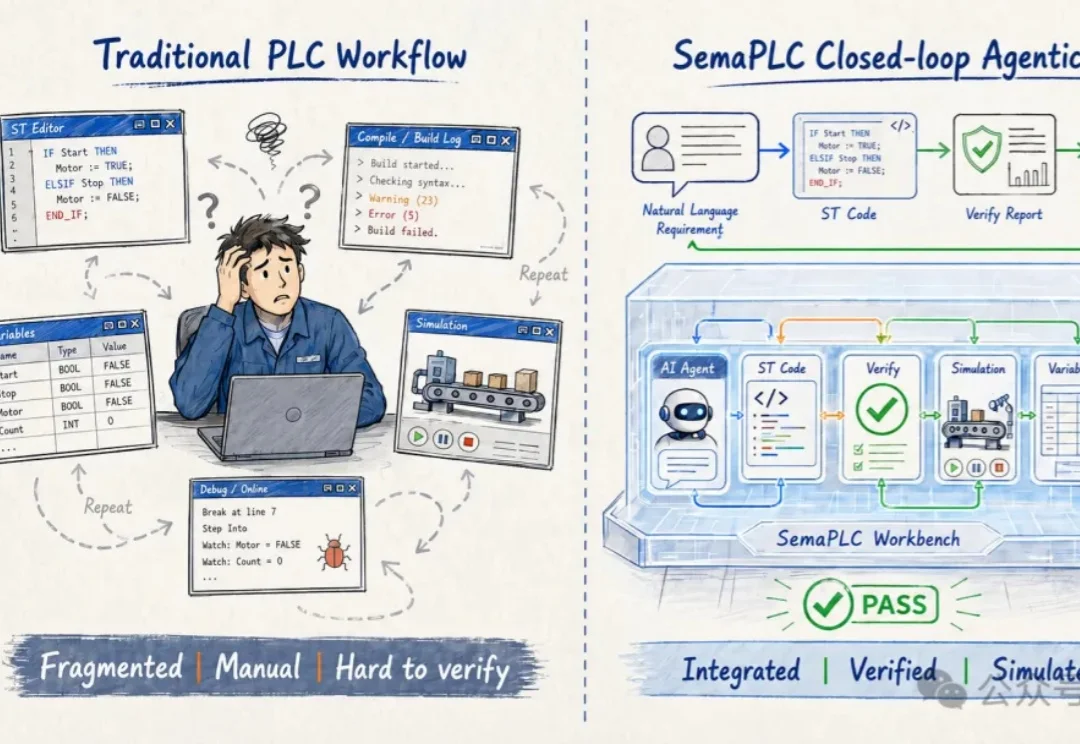
AI正在改变软件开发方式。过去需要从零编写的程序,现在可以用自然语言描述需求,再由AI生成代码初稿。

Qwen3.8-27B开始和顶级闭源模型正面叫板,过度思考是最大问题。

27B正在成为本地AI的新选择。

为什么偏偏是小尺寸模型?为什么是现在?
今日,蚂蚁百灵大模型开源了一款轻量级混合推理MoE模型——Ling-3.0-tiny。该模型总参数量为7.9B,推理时激活参数量为1.3B,主要面向高效本地部署而设计。其同步提供BF16、FP8和INT4三个版本,已在DGX Spark、MacBook、Mac mini等设备上完成验证,兼顾性能、效率与可部署性。

今天,我们正式推出 jina-reranker-v3.5。 作为 v3 系列的进阶版,它依旧保持了 0.6B 的参数规模以及标志性的 LBNL( Last but not late,一次前向传播处理整
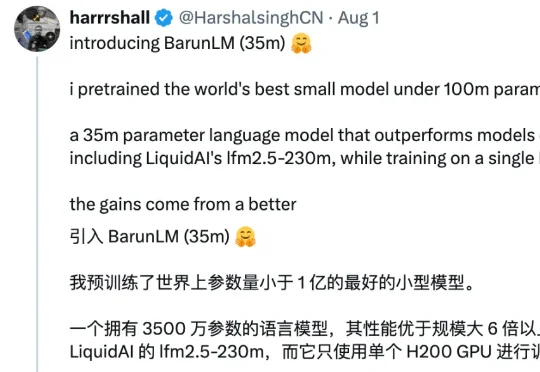
近日,独立开发者 Harshal Singh 公布了一个仅有 3500 万参数的基础语言模型 BarunLM,并声称:「我预训练了世界上参数量小于 100M 的最好模型」。
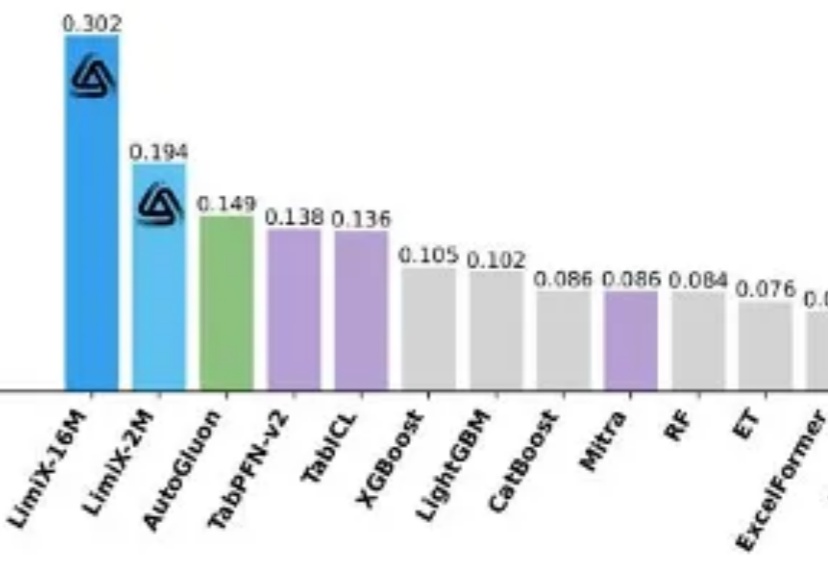
提到 AI 的突破,人们首先想到的往往是大语言模型(LLM):写代码、生成文本、甚至推理多模态内容,几乎重塑了通用智能的边界。但在一个看似 “简单” 的领域 —— 结构化表格数据上,这些强大的模型却频频失手。