NeurIPS 2026 Spotlight|拒绝模型「自作主张」,VisInteract用交互搜索找回意图
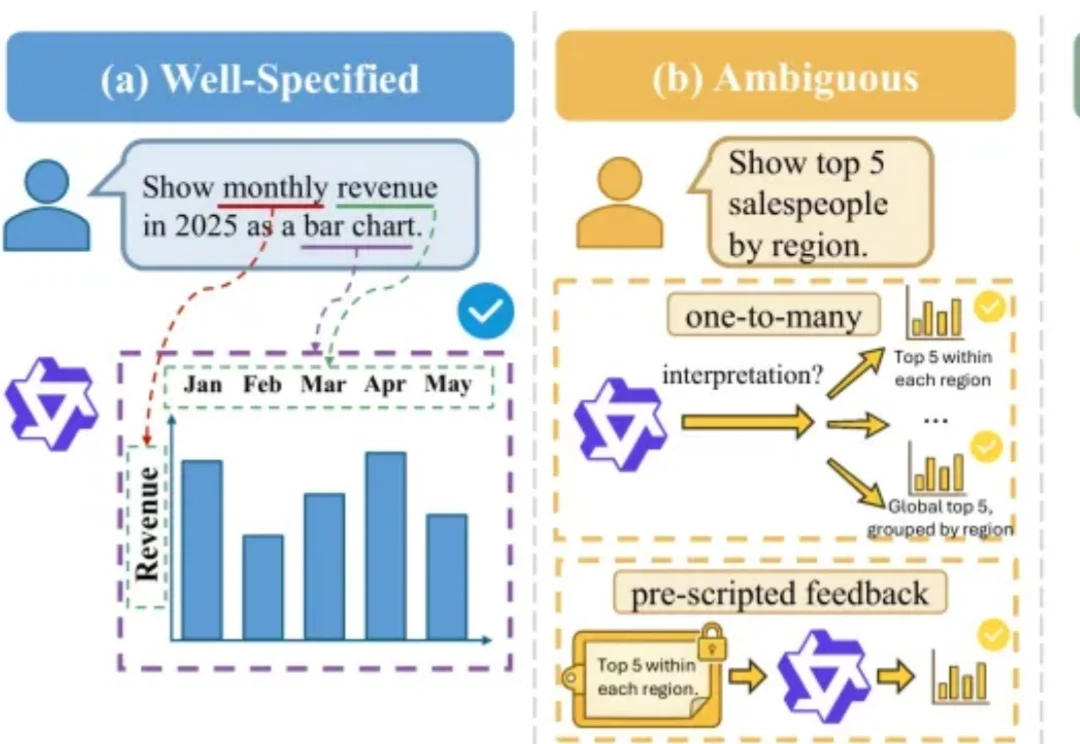
NeurIPS 2026 Spotlight|拒绝模型「自作主张」,VisInteract用交互搜索找回意图数据要让人看懂,通常得先从数据库里查出来,再画成图。文本到可视化(Text-to-Vis)做的就是这件事:用户说出想看什么,系统去库里查询,再用图表把需要的数据展示出来。
来自主题: AI技术研报
9842 点击 2026-10-08 11:26

 搜索
数据要让人看懂,通常得先从数据库里查出来,再画成图。文本到可视化(Text-to-Vis)做的就是这件事:用户说出想看什么,系统去库里查询,再用图表把需要的数据展示出来。
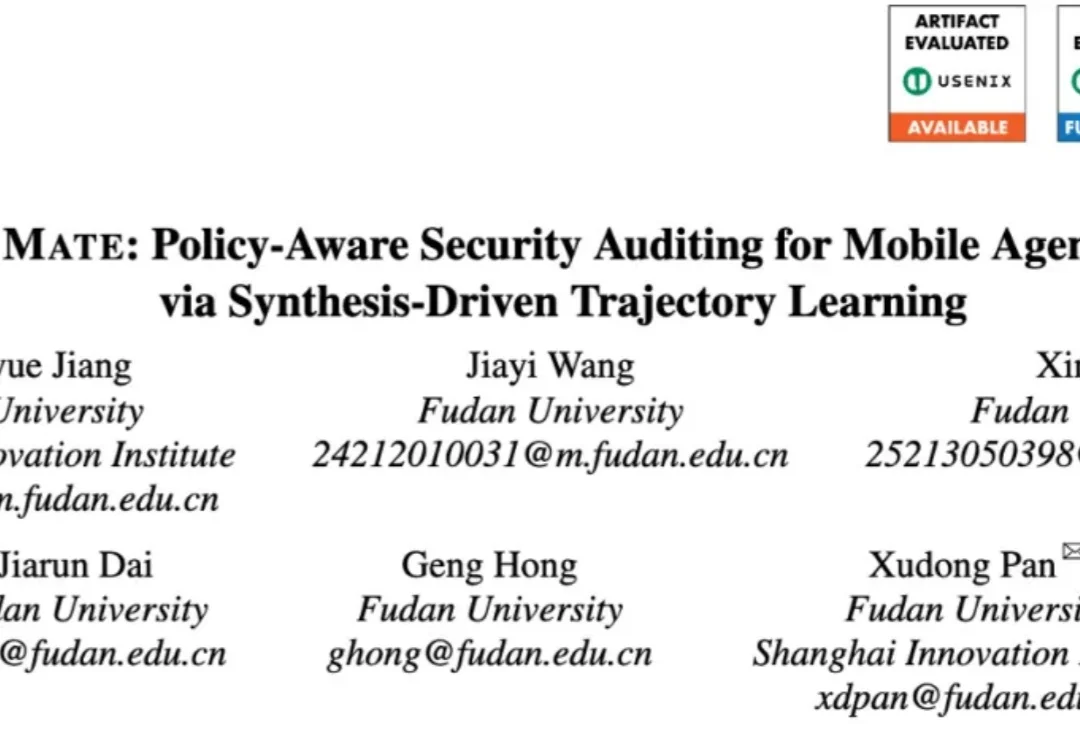
智能体时代,安全研究不仅要关心模型说了什么,现在还必须进一步回答:它做了什么、为什么这么做,以及这次的执行轨迹是否越过了当前场景明确规定的安全边界。
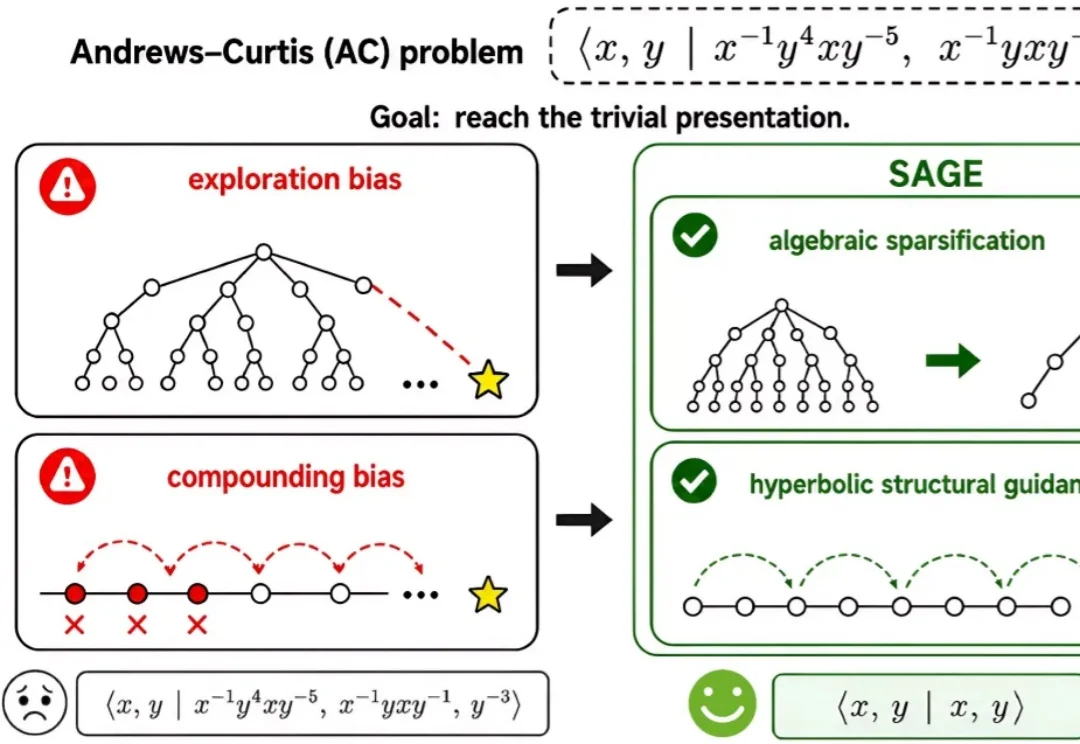
大模型解短题常能给出流畅答案,推理链一长,却可能每一步都看似合理、终点仍然失效。来自弗吉尼亚理工大学、威斯康星大学麦迪逊分校和达特茅斯学院的研究团队在 NeurIPS2026 论文中提出 SAGE:用符号闭包分析(SCA)解释长推理中的探索偏差与累积偏差,再把这一诊断变成训练时的结构引导。
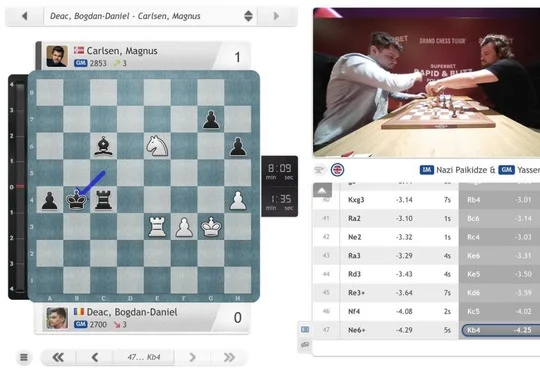
普林斯顿大学陈丹琦团队在arXiv发布约4B参数模型QUEEN,通过门控交叉注意力连接Leela与SmolLM3-3B,并引入四阶段课程和迭代搜索蒸馏,使其棋力接近特级大师且能用自然语言解释着法。
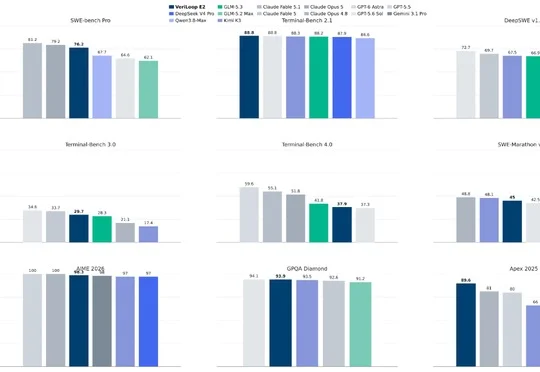
清华团队开源以Qwen 3.8-27B为基础模型的VeriLoop E2,通过VGR外部证据门控实现可验证状态提交,并取得黎曼猜想临界线零点比例下界67.350003708785593%的严格有限维证书,但上游形式化桥接尚未完成。
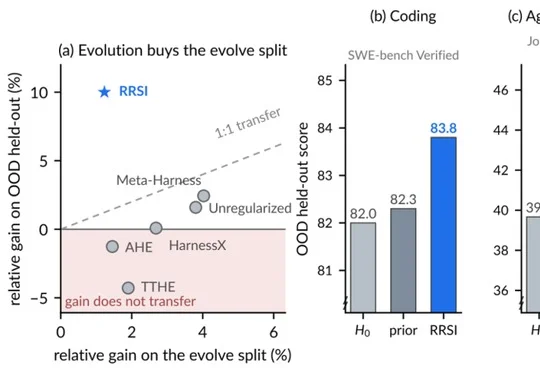
Google等提出RRSI,通过正则化Agent Harness自我改进中的Proposal与Selection,减少过拟合与复杂度累积,并提升未见基准上的迁移表现、降低Token成本。
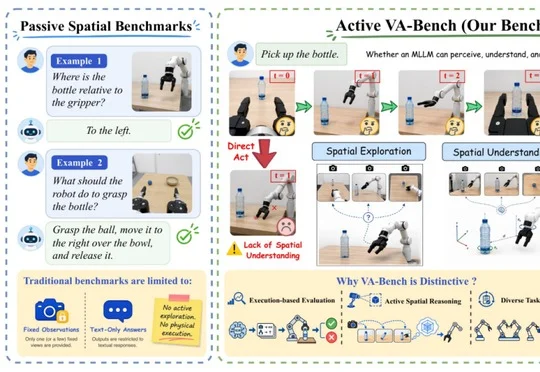
VA-Bench测试12个主要多模态模型发现,Qwen3.8-max、Opus-5和GPT-5.6-sol虽在目标识别与定位上达100%、操作语义理解达99.6%—100%,完整任务成功率却仅为53.93%、52.86%和51.55%,暴露大模型从空间理解到执行与修正的断层。
来自上海创智学院、复旦大学、伦敦国王学院与牛津大学等机构的研究团队推出SocioVerse2,将大模型社会模拟扩展为可干预、可迭代、可回溯的开源社会科学研究框架。
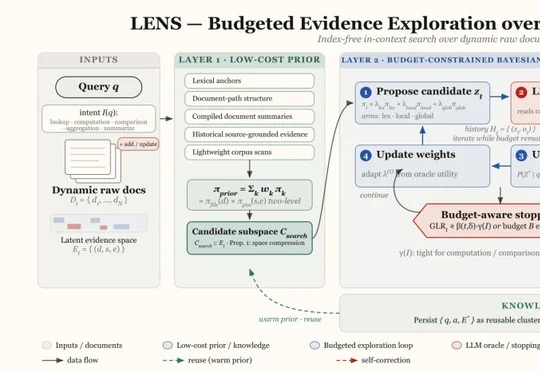
ModelScope团队开源动态检索框架Sirchmunk,无需预构建向量索引即可在原始文件中即时定位证据,并通过KnowledgeEvolver把检索经验沉淀为可复用知识,使知识库在检索过程中持续连接、合并与重组,实现自我进化。
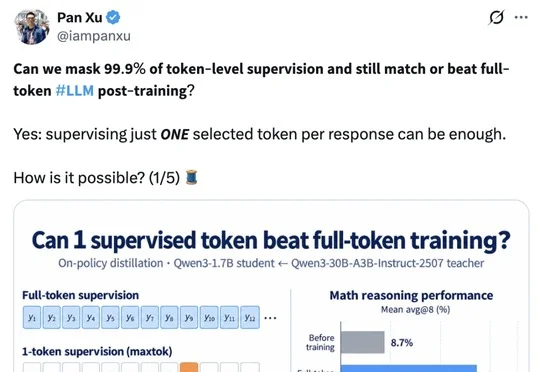
亚马逊公司与杜克大学的研究表明,在大模型后训练的在线策略蒸馏(OPD)中,仅保留万分之一的极端稀疏监督信号即可显著提升学生模型的推理能力,且性能可匹配甚至超越密集全信号训练。