谷歌开源RSI新成果!华人浓度爆表
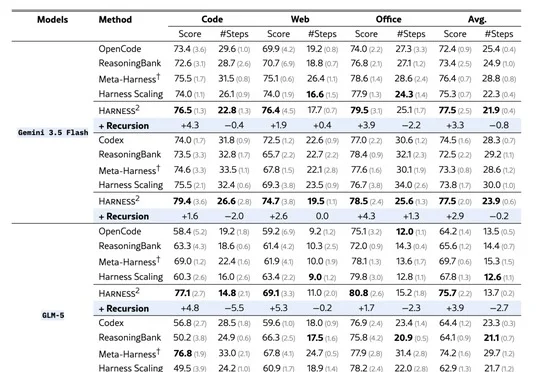
谷歌开源RSI新成果!华人浓度爆表谷歌开源Harness²递归自我改进项目,使大模型无需修改权重即可自主优化外围脚手架,单步改进让GLM-5在WorkBuddy-Bench上提升11.5分。
来自主题: AI资讯
8621 点击 2026-10-19 14:02

 搜索
谷歌开源Harness²递归自我改进项目,使大模型无需修改权重即可自主优化外围脚手架,单步改进让GLM-5在WorkBuddy-Bench上提升11.5分。
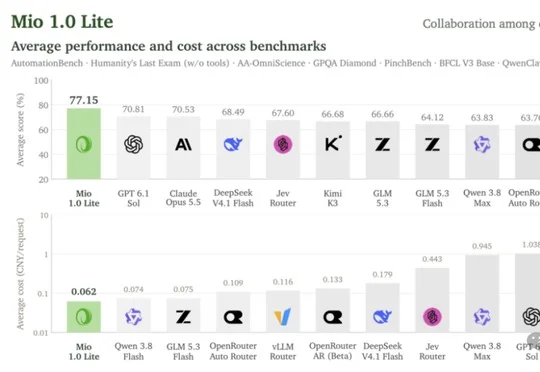
南芥智能(SinapisAI.com)发布技术报告称,Mio 1.0 Lite通过调度多款国产模型,在九项公开基准中以77.15分排名第一,每次请求平均成本约0.062元。
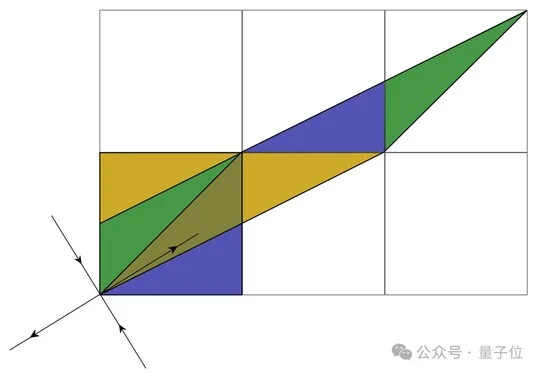
大湾区大学许地生教授团队与上海AI实验室借助书生-S2科学基础模型证明Ghys猜想在复余维一情形下成立,北京大学董彬教授、刘若川院士团队随后完成形式化验证。
世界模型赛道仍在源源不断涌入最智慧的大脑。
近日,Manifold AI流形空间登顶机器人学习基准RoboDojo榜单(Agent Track),超越 GPT-6-Astra、英伟达 GR00T-N1.。其 WorldScape R²SI系统超过GPT-6-Astra、英伟达 GR00T-N1.7等模型,位列总榜第一。
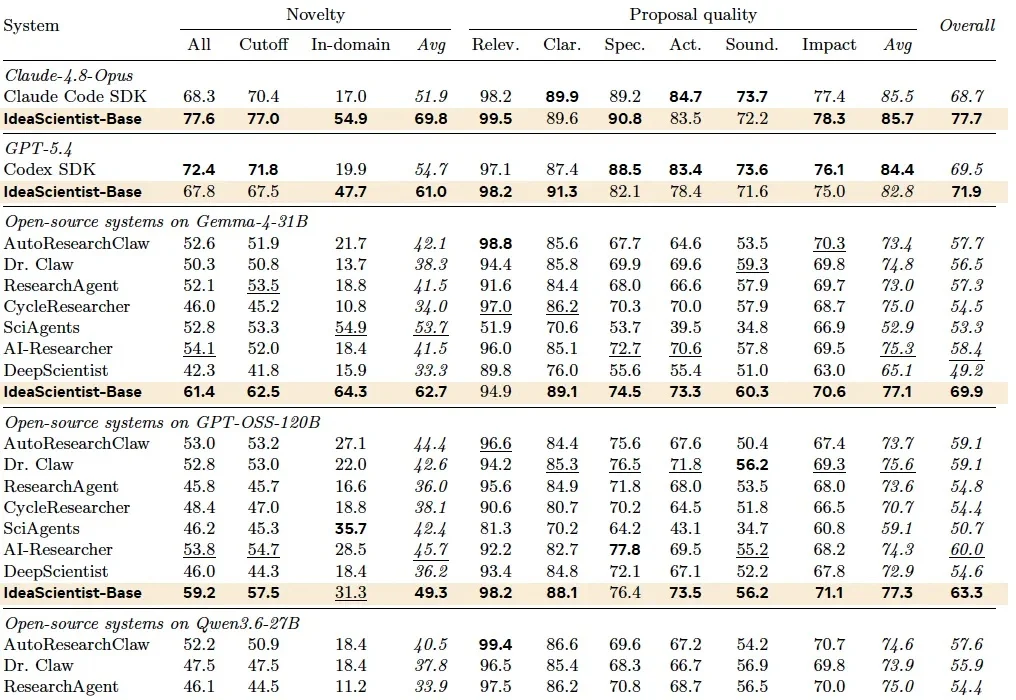
都知道跨学科才能拿大结果,可啃完全陌生的领域又太烧心?
设定一些不合理的目标,然后告诉模型:这非常合理!
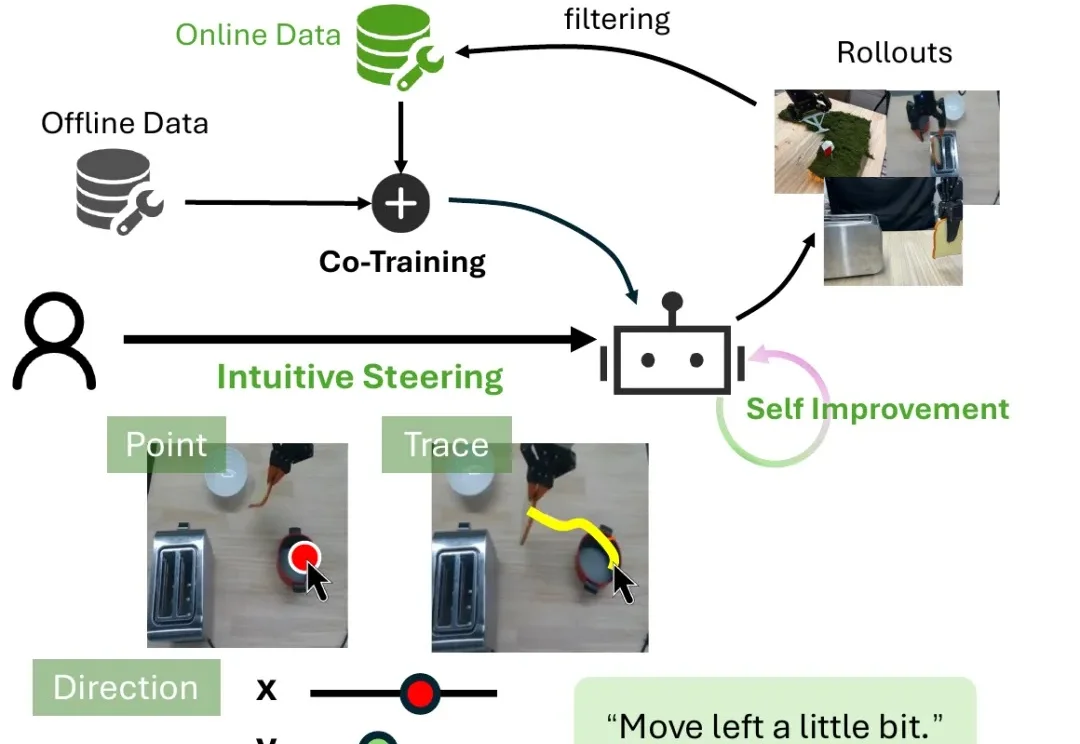
看着机器人抓偏了杯子、迟迟对不准面包机的插口,人们可能会忍不住提醒:“往左一点,再往前一点。”这些对人类来说再简单不过的调整,对机器人却未必容易。
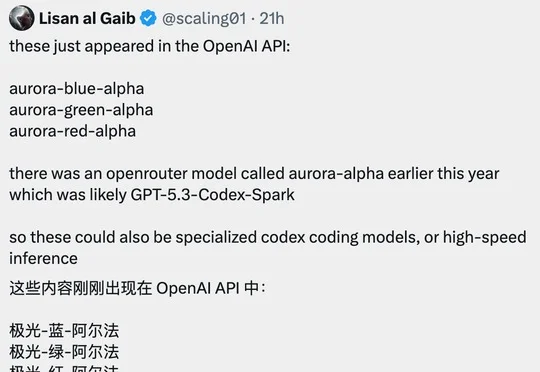
OpenAI API 模型列表短暂出现 aurora-red-alpha、aurora-green-alpha 和 aurora-blue-alpha,随后被移除,Arena 盲测显示三者可能均为生图模型,但 OpenAI 尚未确认其身份。
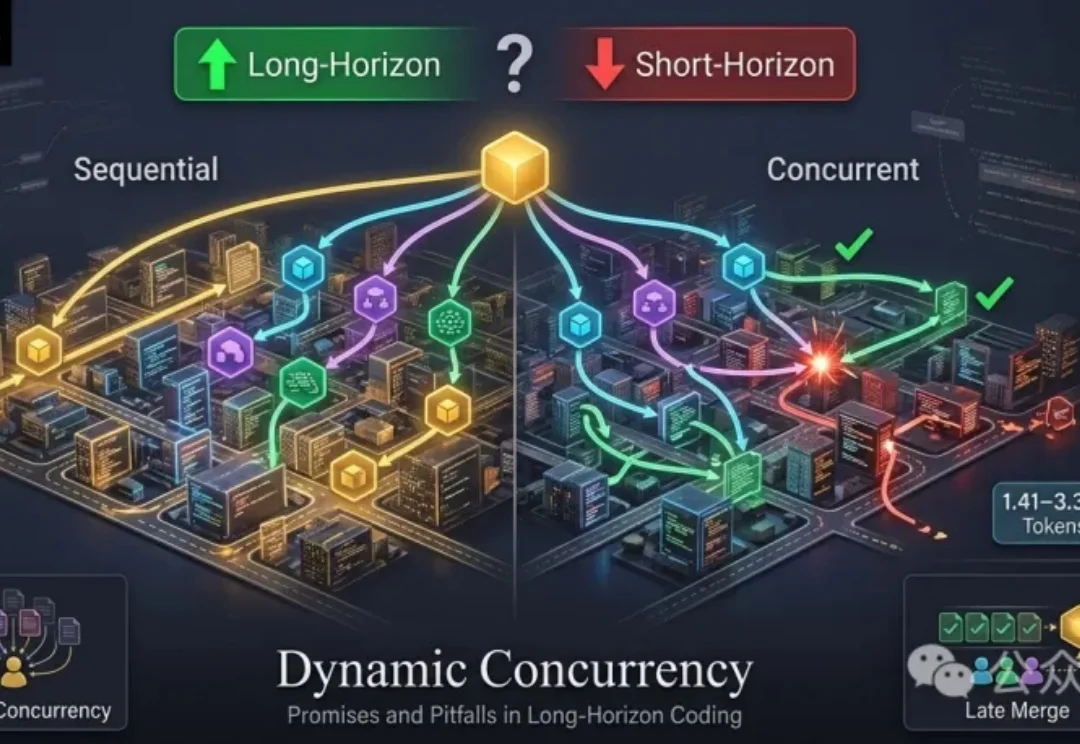
Coding Agent正在进入新的发展阶段。过去,它们主要修复Bug、解决GitHub Issue或实现相对独立的功能,SWE-bench等Benchmark已为此建立了成熟评测范式;如今它们开始承担从完整代码仓库生成、跨语言迁移,到需要持续探索与验证的长周期软件工程项目,任务规模和执行时间不断增长,单个Agent的上下文容量、推理能力和执行效率逐渐成为限制。