AI资讯新闻榜单内容搜索-模型

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: 模型
登顶RoboChallenge Table30!LoopWAM开源,与pi的部署自进化理念不谋而合

登顶RoboChallenge Table30!LoopWAM开源,与pi的部署自进化理念不谋而合

登顶RoboChallenge Table30!LoopWAM开源,与pi的部署自进化理念不谋而合

近日,由清华大学、原力灵机与极寰时代联合研发的世界动作模型LoopWAM,登顶真机评测榜单RoboChallenge Table30 V2,成功率与过程分双双位列榜首,成绩超过VLA-DM0.5等同期方案。同时,LoopWAM在仿真榜单RoboTwin 2.0和RoboCasa365上同样取得SOTA表现。

来自主题: AI技术研报
7397 点击    2026-10-20 12:19
GPT-6-Astra具身能力遭大考!传统基准拿满分,真机频碰壁

GPT-6-Astra具身能力遭大考!传统基准拿满分,真机频碰壁

GPT-6-Astra具身能力遭大考!传统基准拿满分,真机频碰壁

上月发布 GPT-6-Astra 时,OpenAI 称它为「全球智能程度最高且最符合人类意图的模型」。具身社区则是惊讶的发现,VLA vs WAM 的路线之争,被通用大模型用文字模态「降维打击」了,大家不禁想问:

来自主题: AI技术研报
8257 点击    2026-10-20 12:19
通研院孵化的团队,也盯上了RSI

通研院孵化的团队,也盯上了RSI

通研院孵化的团队,也盯上了RSI

从通用模型到个性化智能,人工智能的竞争正在向长期学习与专属能力沉淀延伸。

来自主题: AI资讯
7403 点击    2026-10-20 11:57
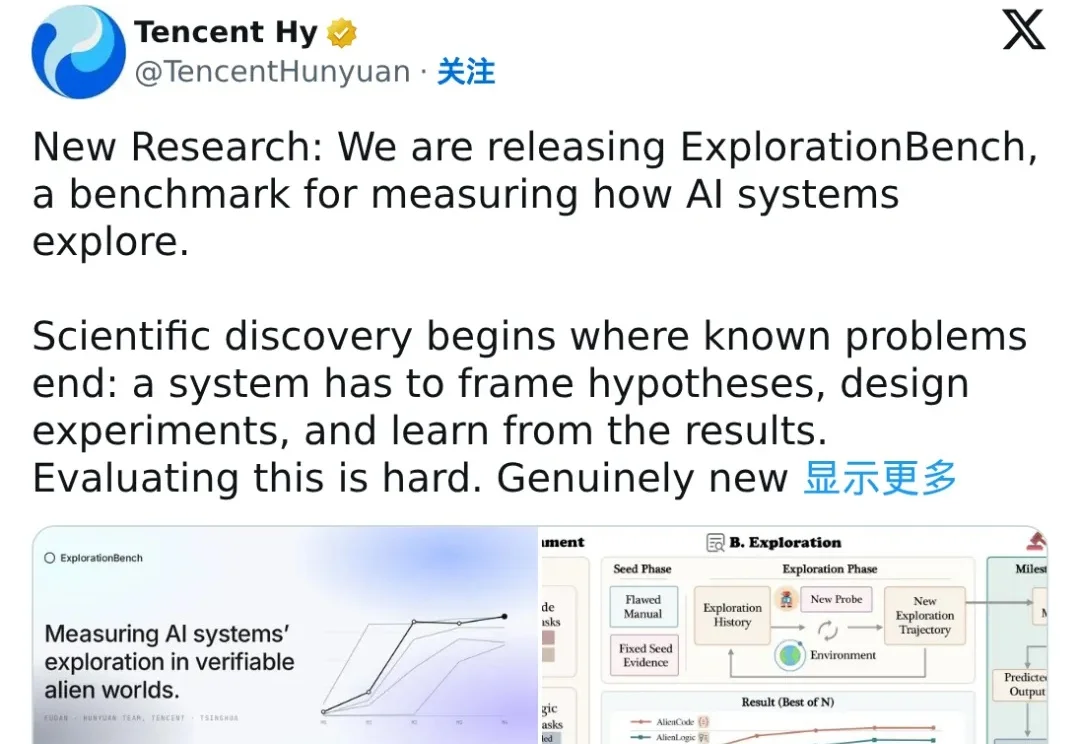
该如何评测大模型的探索能力?复旦、混元发布新基准ExplorationBench

该如何评测大模型的探索能力?复旦、混元发布新基准ExplorationBench

该如何评测大模型的探索能力?复旦、混元发布新基准ExplorationBench

近日,腾讯混元官方账号(@TencentHunyuan)在 X 上发布了一项新研究:ExplorationBench,一个专门衡量 AI 系统如何「探索」的评测基准;随后,腾讯 AI 官方账号(@TencentAI_News)也发文进行了专题推介。

来自主题: AI技术研报
7388 点击    2026-10-20 11:57
Agent做减法,砍掉九成Harness模块反而更聪明!UCSB、MIT-IBM提出SHARP剪枝法

Agent做减法,砍掉九成Harness模块反而更聪明!UCSB、MIT-IBM提出SHARP剪枝法

Agent做减法,砍掉九成Harness模块反而更聪明!UCSB、MIT-IBM提出SHARP剪枝法

Agent在真实任务中出错,工程师的第一反应往往是给Harness“打补丁”:加一条防错提示词、接入一个新工具、挂一套Skills,或者增加历史摘要和执行检查。这套负责协调模型调用、工具执行与上下文管理的外层系统,就是Agent Harness。

来自主题: AI技术研报
10405 点击    2026-10-20 11:29
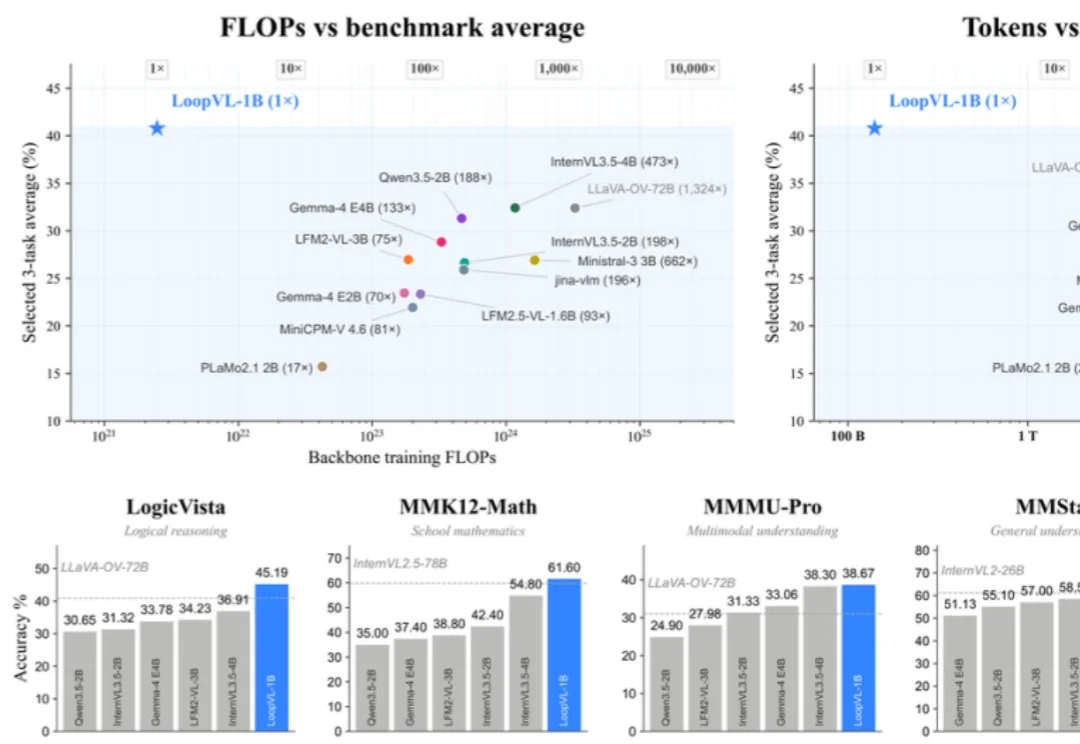
Loop Transformer走向视觉语言模型,百度联合清华人大高瓴开源LoopVL

Loop Transformer走向视觉语言模型,百度联合清华人大高瓴开源LoopVL

Loop Transformer走向视觉语言模型,百度联合清华人大高瓴开源LoopVL

近年来,Loop Transformer 逐渐从简单的模块复用走向更复杂的分层循环计算,探索如何通过共享参数持续更新模型状态。一个自然的问题是:当模型开始看图,这套机制还成立吗?

来自主题: AI技术研报
9015 点击    2026-10-20 11:24