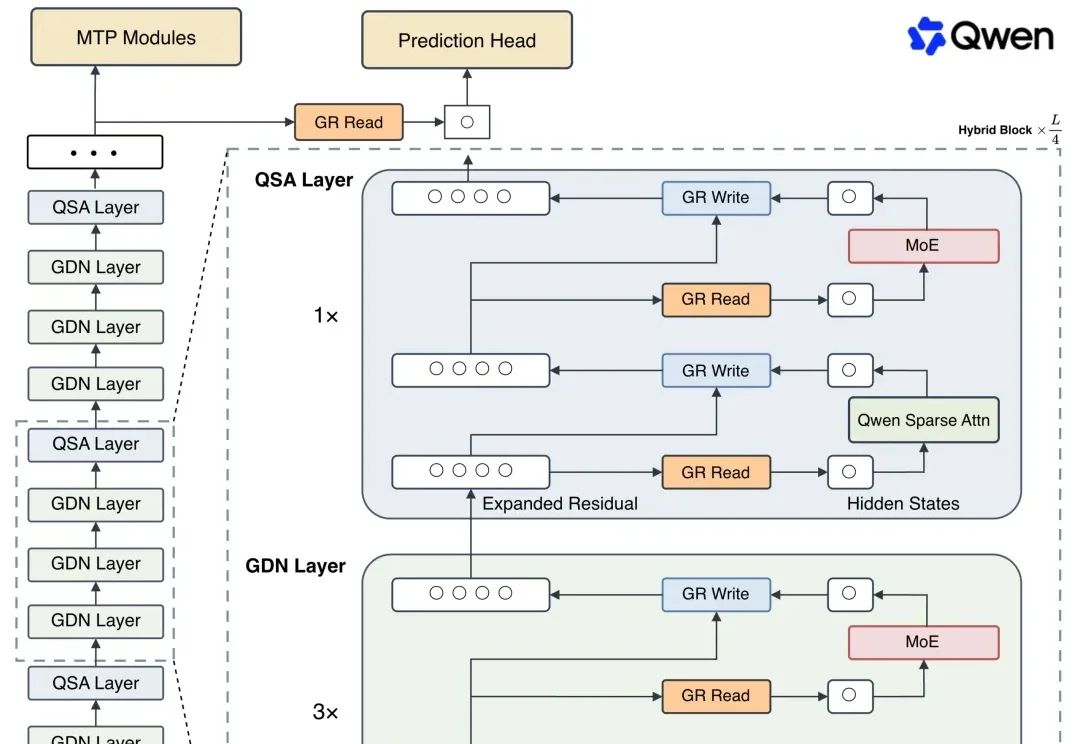
Qwen 4用上DeepSeek的Engram!125B MoE一张4090能跑不用量化
Qwen 4用上DeepSeek的Engram!125B MoE一张4090能跑不用量化Qwen4还没出,架构先开源了。
来自主题: AI技术研报
9851 点击 2026-08-28 12:02

 搜索
Qwen4还没出,架构先开源了。
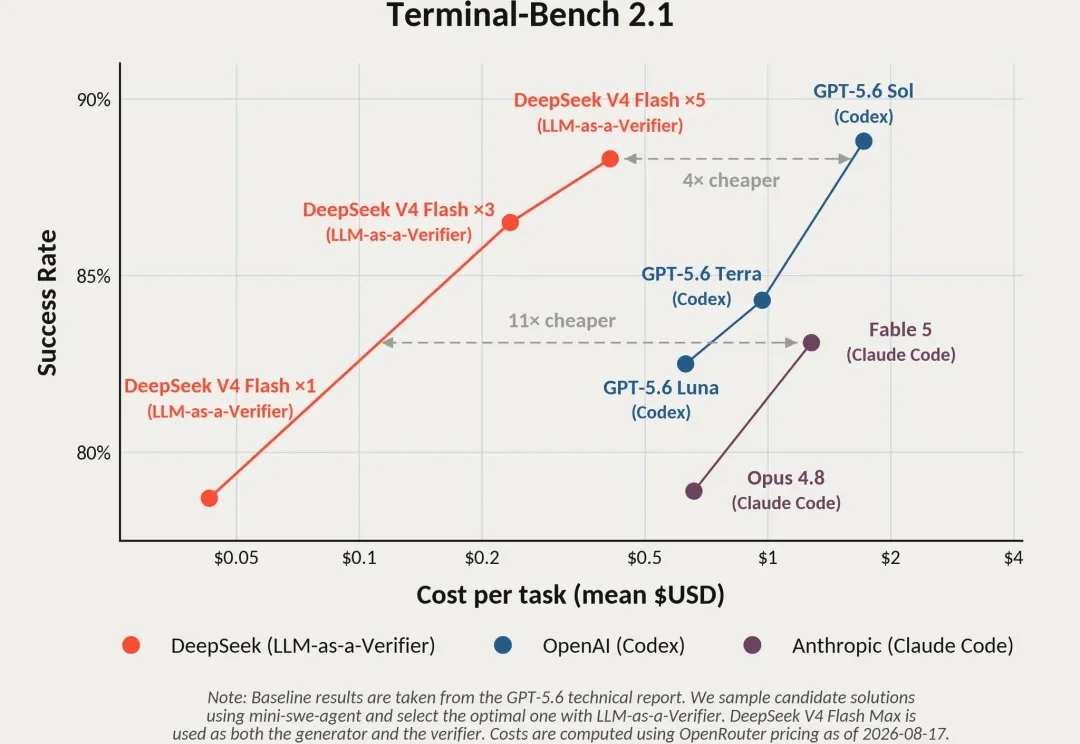
随着开源模型能力不断提升,它们已经能够以极低的成本生成多个高质量候选方案,并进一步利用模型自身对这些结果进行验证、打分和筛选。斯坦福团队最新实验发现,使用 DeepSeek V4 Flash + LLM-as-a-Verifier 进行「自验证」,可以在 Terminal-Bench 2.1 上超越 Claude Fable 5,同时整体成本低约 11 倍。
8月14日,一个叫Cocode的项目悄悄出现在GitHub上,简介写得很直白,基于DeepSeek Harness构建的开箱即用发行版。不到两周,它拿到150多个star,并在8月25日发布了v1.0.2。
说真的,现在谁还能完全离开AI工作?
昨晚,孙割写的小作文爆火。具体的小作文详情我就不放了,应该传的满天都是,感兴趣的可以去孙割的GitHub上看。但是就别问我孙割具体的GitHub链接是什么,你可以直接复制这个问题去问AI。
不得不说,这真是我参加过最「全自动」的产品发布会……台上还在讲,台下已经开始出片了???新闻稿、产品长图、嘉宾金句海报、现场高光视频……一个接一个往外冒,简直是「实时转录」。
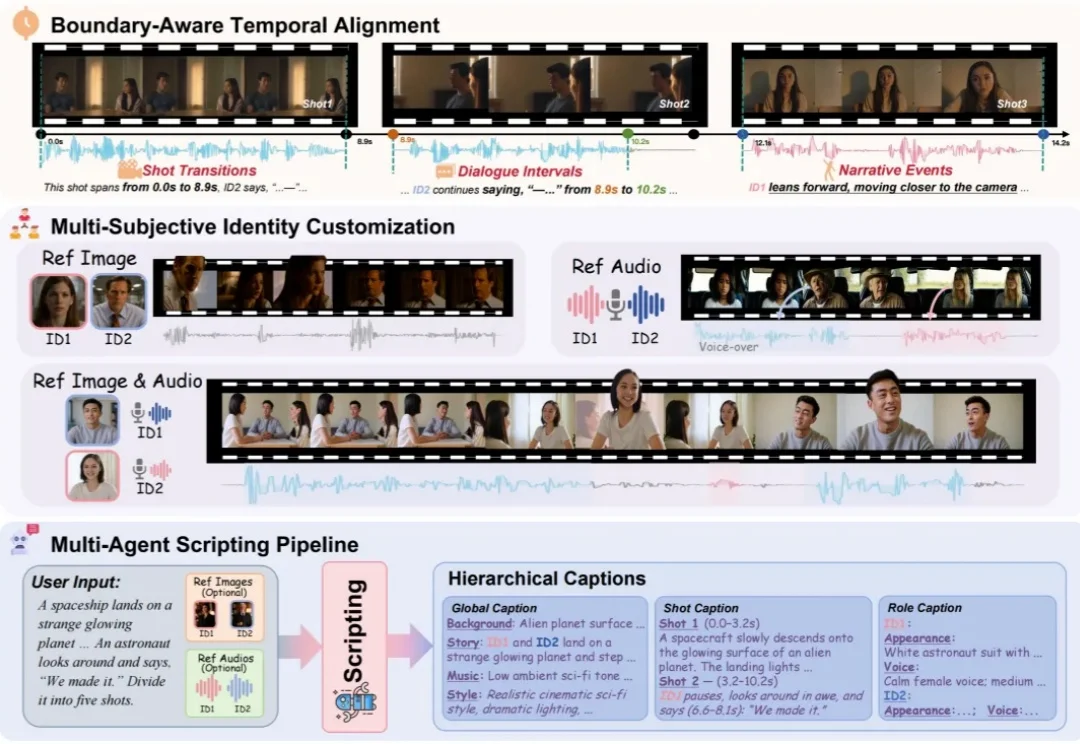
过去几年,视频生成模型在清晰度、运动表现和画面质感上不断进步。输入一句文字,模型已经能够生成颇具电影感的视频。
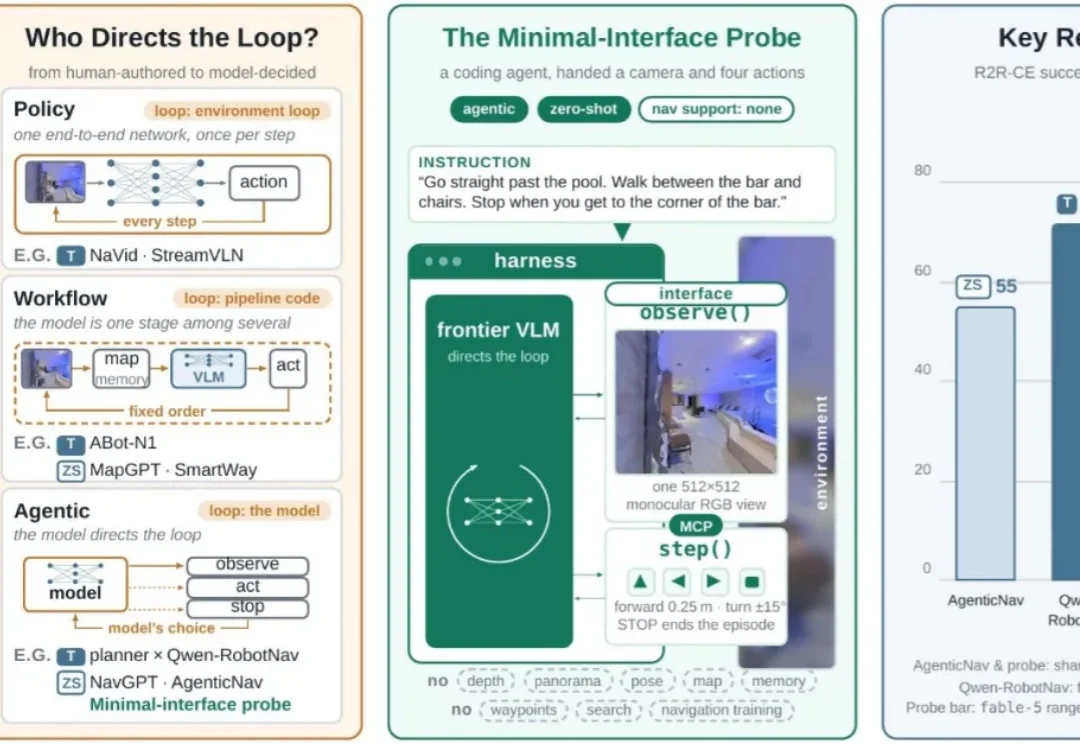
不建图、不记忆、零训练:coding-agent 被直接扔进屋里,导航成绩反超工业级专用模型。
过去两年,大模型几乎重写了人机协作的默认想象:写代码、查资料、做分析,似乎都能 “一问即答”。但仔细看会发现,当下很多能力并不是模型自己长出来的,而是人为地在外面包了一层又一层框架。
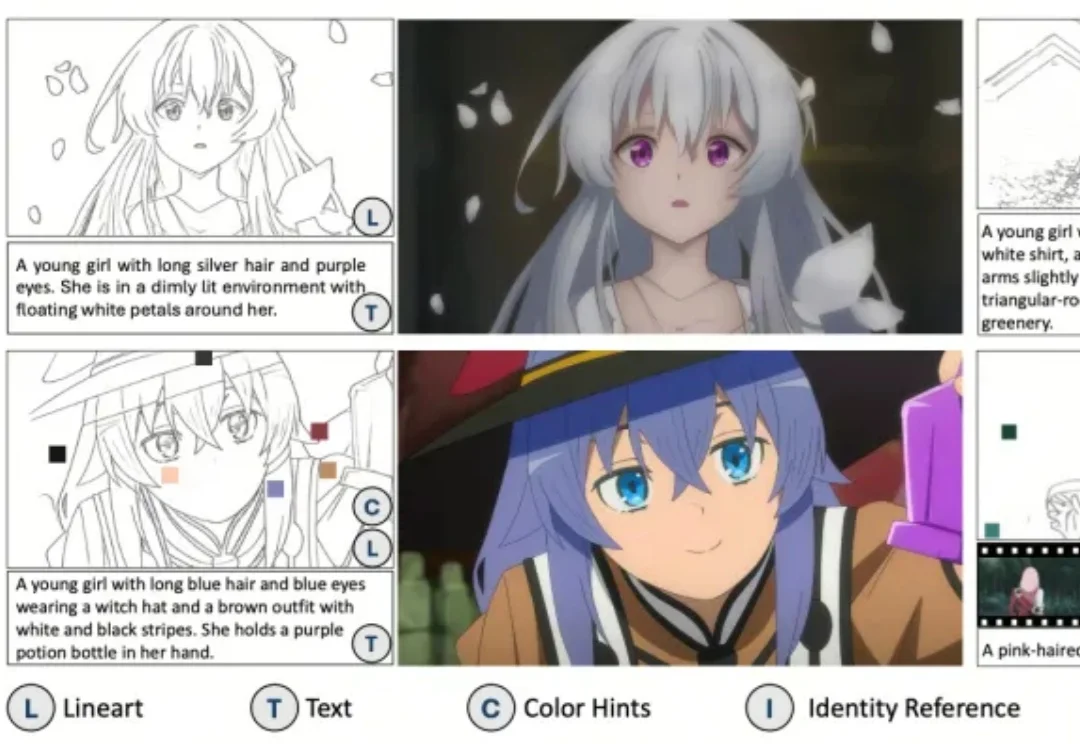
在动画和美术生产中,线稿上色是一个看似基础、却极其依赖细节控制的环节。创作者往往不是简单地把线稿涂上颜色,还需要理解角色身份、遵守局部色块约束、参考前后帧风格,并在连续片段中保持服装、发色、妆容和背景的一致性。