只要强化学习1/10成本!翁荔的Thinking Machines盯上了Qwen的黑科技
只要强化学习1/10成本!翁荔的Thinking Machines盯上了Qwen的黑科技今天要讲的On-Policy Distillation(同策略/在线策略蒸馏)。这是一个Thinking Machines整的新活,这个新策略既有强化学习等在线策略方法的相关性和可靠性;又具备离线策略(Off-policy)方法的数据效率。
搜索
今天要讲的On-Policy Distillation(同策略/在线策略蒸馏)。这是一个Thinking Machines整的新活,这个新策略既有强化学习等在线策略方法的相关性和可靠性;又具备离线策略(Off-policy)方法的数据效率。
刚刚,这样一个消息在 Reddit 上引发热议:硅谷似乎正在从昂贵的闭源模型转向更便宜的开放源替代方案。
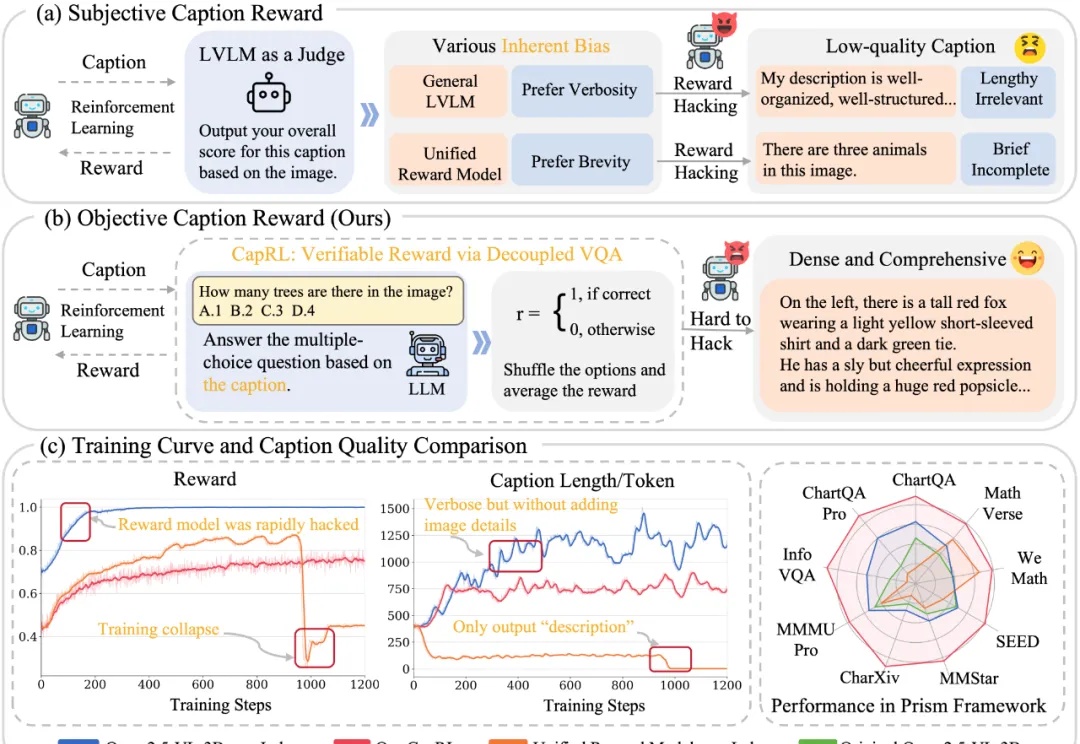
今天推荐一个 Dense Image Captioning 的最新技术 —— CapRL (Captioning Reinforcement Learning)。CapRL 首次成功将 DeepSeek-R1 的强化学习方法应用到 image captioning 这种开放视觉任务,创新的以实用性重新定义 image captioning 的 reward。
大语言模型(LLMs)推理能力近年来快速提升,但传统方法依赖大量昂贵的人工标注思维链。中国科学院计算所团队提出新框架PARO,通过让模型学习固定推理模式自动生成思维链,只需大模型标注1/10数据就能达到全量人工标注的性能。这种方法特别适合像金融、审计这样规则清晰的领域,为高效推理监督提供了全新思路。
在当前评测生成式模型代码能力的浪潮中,传统依赖人工编写的算法基准测试集,正日益暴露出可扩展性不足与数据污染严重两大瓶颈。
直到我看到 Dedalus Labs 宣布完成 1100 万美元种子轮融资的消息,才意识到有人正在系统性地解决这个问题。这家由 Cathy Di 和 Windsor Nguyen 创立的公司,正在构建一个基础设施层,让开发者能够用 5 行代码就搭建起一个功能完整的 AI agent。这不是夸张的营销话术,而是他们真正在做的事情。
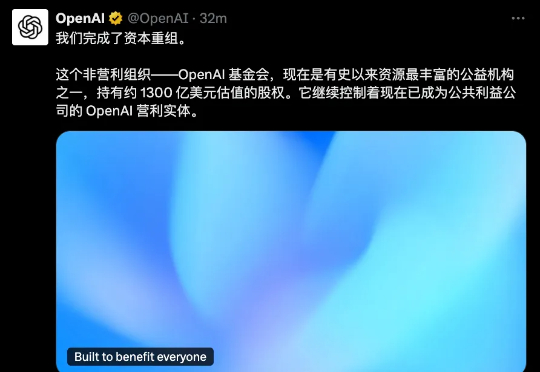
刚刚,OpenAI宣布已完成资本结构重组。这就意味着,OpenAI上市的道路已经铺平,而软银前几天刚批准的225亿美元投资,也将顺利到账。具体来说,OpenAI重组后,非营利主体(即原本的OpenAI Nonprofit)改名为OpenAI Foundation,继续掌控营利实体——
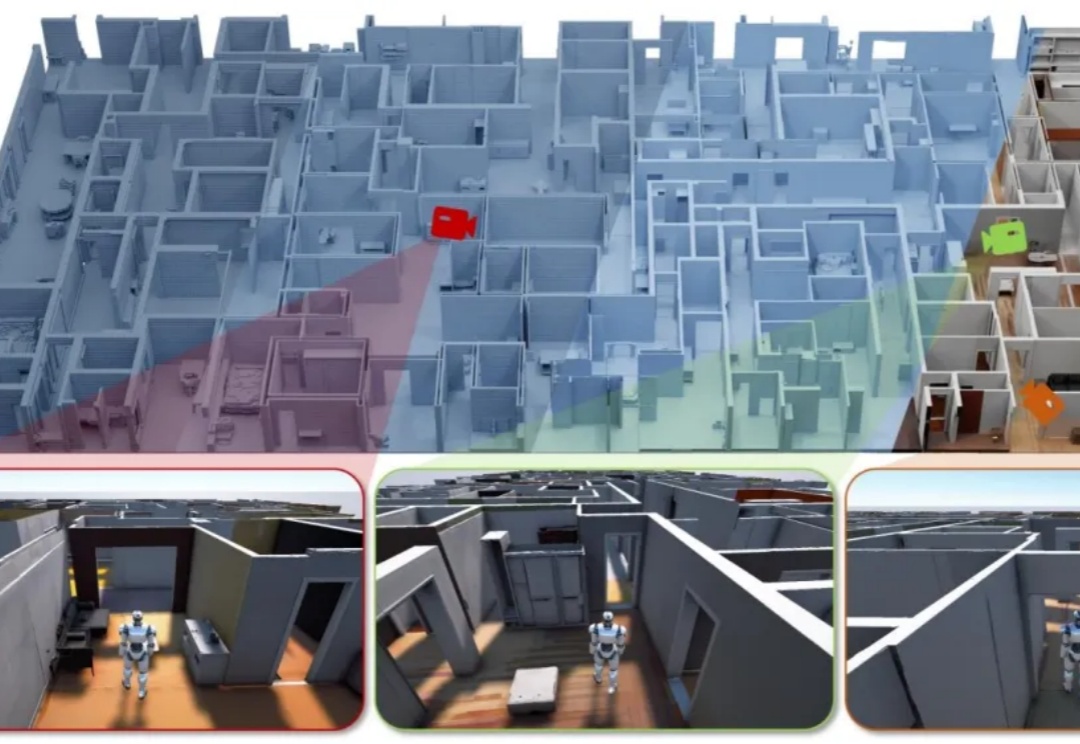
AI大house真来了。
凌晨三点,一个用户在 ChatGPT 的对话框里输入,「我已经没有办法再坚持了。」
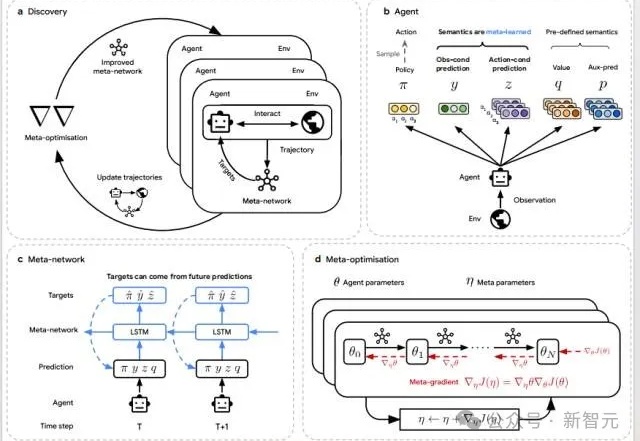
当AI开始「自己学会学习」,人类的角色正在被重写。DeepMind最新研究DiscoRL,让智能体在多环境交互中自主发现强化学习规则——无需人类设计算法。它在Atari基准中击败MuZero,在从未见过的游戏中依旧稳定高效。