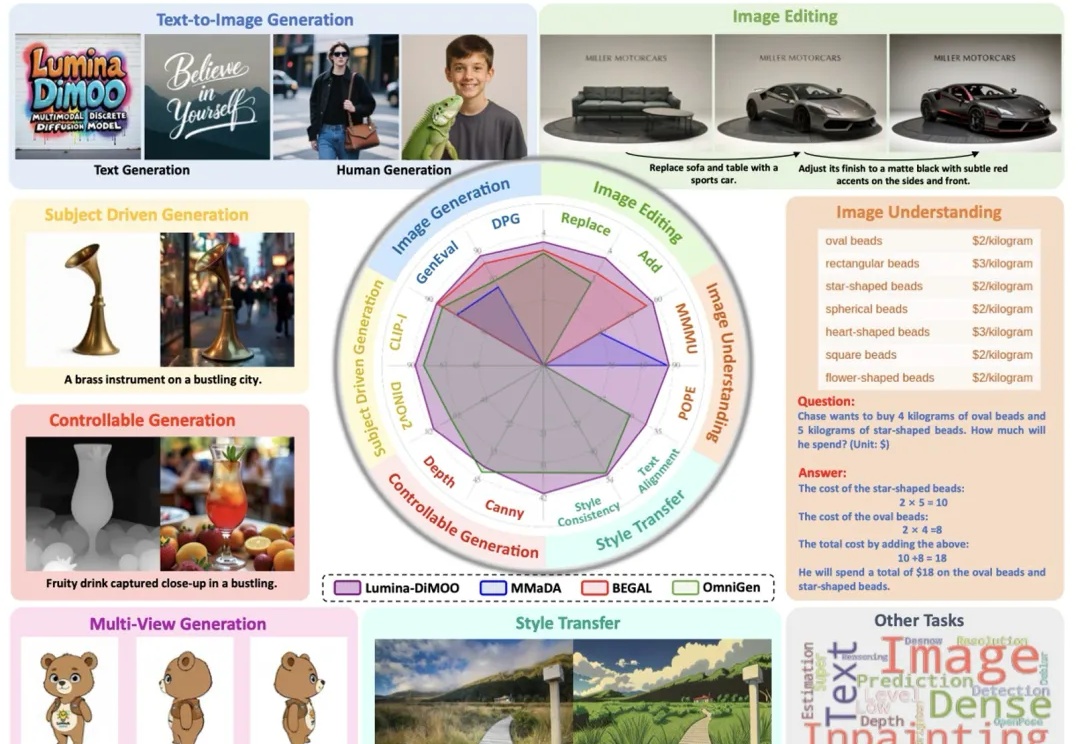
Lumina-DiMOO:多模态扩散语言模型重塑图像生成与理解
Lumina-DiMOO:多模态扩散语言模型重塑图像生成与理解上海人工智能实验室推出了一款革新的多模态生成理解一体化的扩散语言模型 ——Lumina-DiMOO。基于离散扩散建模(Discrete Diffusion Modeling),Lumina-DiMOO 打破了多模态任务之间的壁垒,在同一离散扩散框架下,完成从 文本→图像、图像→图像、图像→文本的全栈能力闭环。
搜索
上海人工智能实验室推出了一款革新的多模态生成理解一体化的扩散语言模型 ——Lumina-DiMOO。基于离散扩散建模(Discrete Diffusion Modeling),Lumina-DiMOO 打破了多模态任务之间的壁垒,在同一离散扩散框架下,完成从 文本→图像、图像→图像、图像→文本的全栈能力闭环。
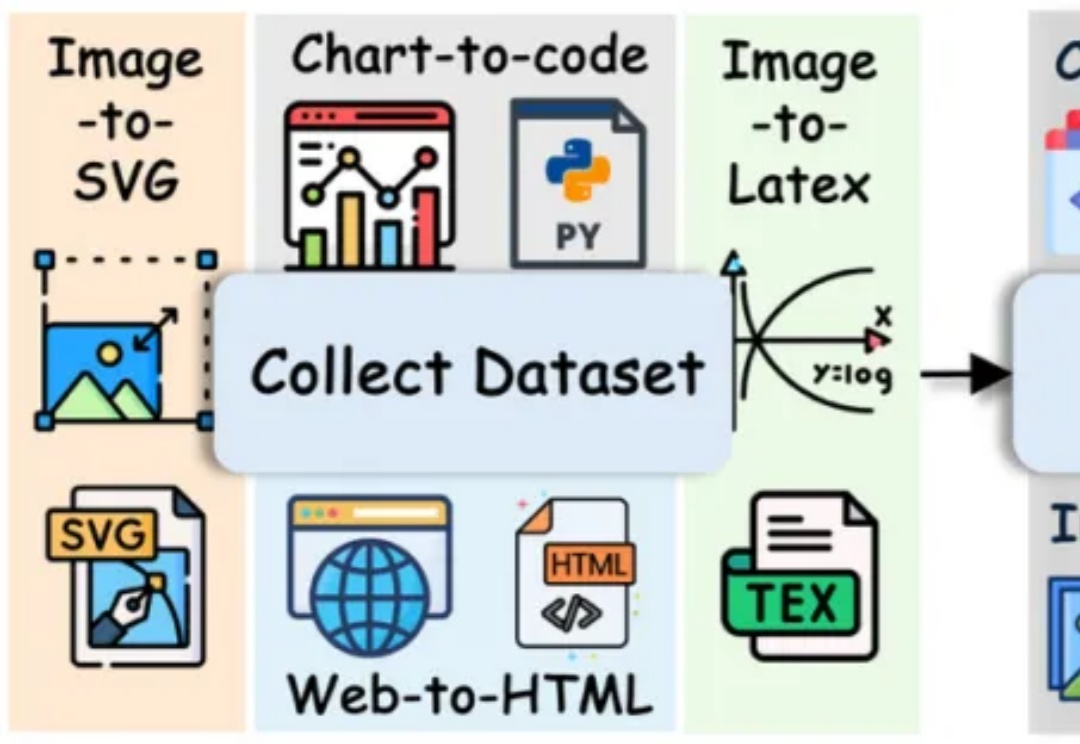
长期以来,多模态代码生成(Multimodal Code Generation)的训练严重依赖于特定任务的监督微调(SFT)。尽管这种范式在 Chart-to-code 等单一任务上取得了显著成功 ,但其 “狭隘的训练范围” 从根本上限制了模型的泛化能力,阻碍了通用视觉代码智能(Generalized VIsioN Code Intelligence)的发展 。
今年刚满 20 岁的中山大学 00 后本科毕业生沙天铭,前不久收到了多所全美 Top50 高校的博士 offer。同样在前不久,他和合作者为预防中风研发出一款名为 FAST-CAD 的 AI 工具,能在不依赖医院设备的前提下,在复杂的日常环境中实现中风的准确判断。
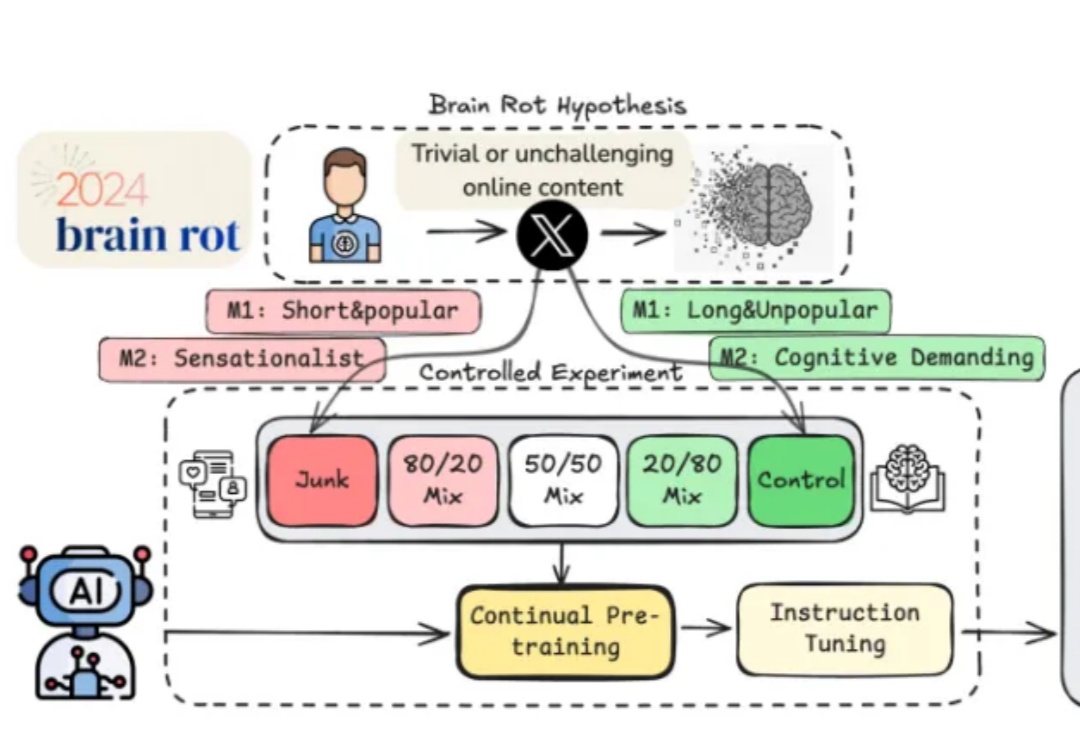
你知道有个全球年度词汇叫“脑损伤”(Brain Rot)吗?
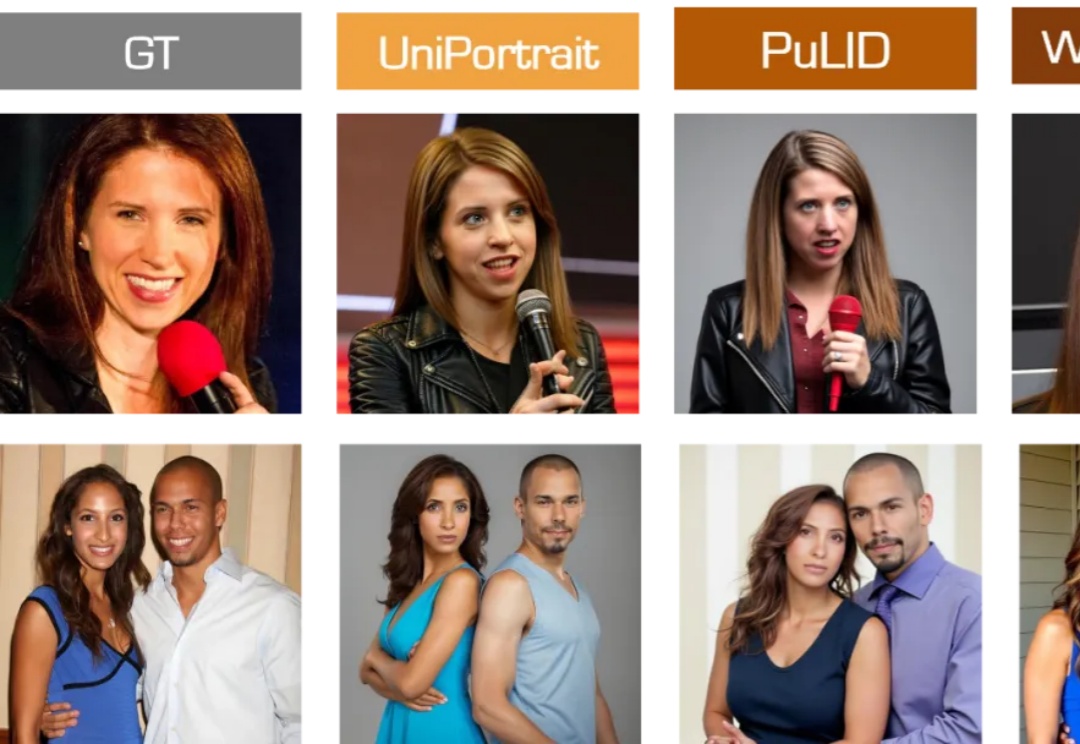
和任何人,去任何地方!复旦大学携手阶跃星辰打破 “复制粘贴” 魔咒,重磅推出全新 AI 合照生成模型 WithAnyone —— 只需上传照片,就能一键生成自然、真实、毫无违和感的 AI 合照!
✅ 大概是互联网里最讨喜的 emoji 了。
在多模态智能浪潮中,视觉语言模型(Vision-Language Models, VLM)已成为连接视觉理解与语言生成的核心引擎。从图像描述、视觉问答到 AI 教育和交互系统,它们让机器能够「看懂世界、说人话」。
4万亿苹果帝国迎来终极悬念:掌门人库克或将2026年交棒。在AI重新定义科技格局的今天,苹果为何急于寻找接班人?传闻中的热门继承人John Ternus,这位M芯片背后的功臣,是临危受命的创新者,还是库克模式的延续者?他能否带领苹果开启新篇章?
在大模型研究领域,做混合专家模型(MoE)的团队很多,但专注机制可解释性(Mechanistic Interpretability)的却寥寥无几 —— 而将二者深度结合,从底层机制理解复杂推理过程的工作,更是凤毛麟角。
如何将情感价值落地转化为市场价值,是AI陪伴赛道面临的共性问题。