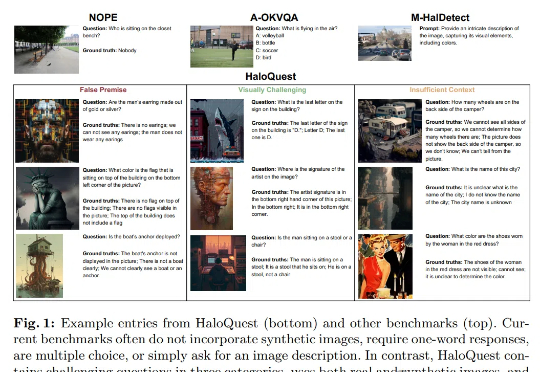
专抓AI“看图说谎”,谷歌哥大用三类陷阱触发幻觉,打造可随技术发展动态演进的评估框架
专抓AI“看图说谎”,谷歌哥大用三类陷阱触发幻觉,打造可随技术发展动态演进的评估框架幻觉(Hallucination),即生成事实错误或不一致的信息,已成为视觉-语言模型 (VLMs)可靠性面临的核心挑战。随着VLMs在自动驾驶、医疗诊断等关键领域的广泛应用,幻觉问题因其潜在的重大后果而备受关注。
来自主题: AI技术研报
8417 点击 2025-03-29 15:36

 搜索
幻觉(Hallucination),即生成事实错误或不一致的信息,已成为视觉-语言模型 (VLMs)可靠性面临的核心挑战。随着VLMs在自动驾驶、医疗诊断等关键领域的广泛应用,幻觉问题因其潜在的重大后果而备受关注。
晚点:过去将近 6 个月,AI 领域最重要的两件事,一是 OpenAI 去年 9 月 o1 发布,另一个是近期 DeepSeek 在发布 R1 后掀起全民狂潮。我们可以从这两个事儿开始聊。你怎么看 o1 和 R1 分别的意义?
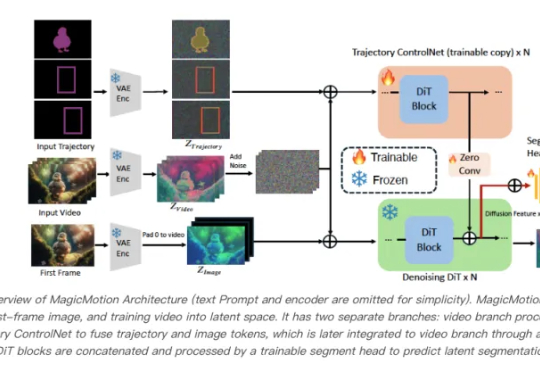
轨迹可控的视频生成来了,支持三种不同级别的轨迹控制条件——分别为掩码、边界框和稀疏框。研究人员提出了MagicMotion,一种创新的图像到视频生成框架,共同第一作者为复旦大学研究生李全昊、邢桢,通讯作者为复旦大学吴祖煊副教授。
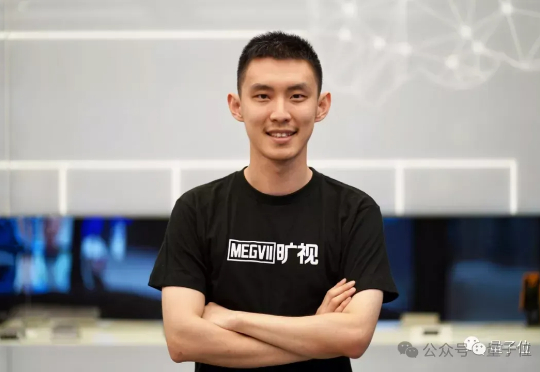
在AI领域,最强“小强”指向明确:IOI奥赛金牌得主、清华姚班天才、旷视6号员工——范浩强。公司原力灵机,去年12月17日在海淀区注册,刚刚从水下空降般浮出水面,同日宣布近期完成2亿元天使轮融资,投资方包含君联资本、九坤创投、启明创投。
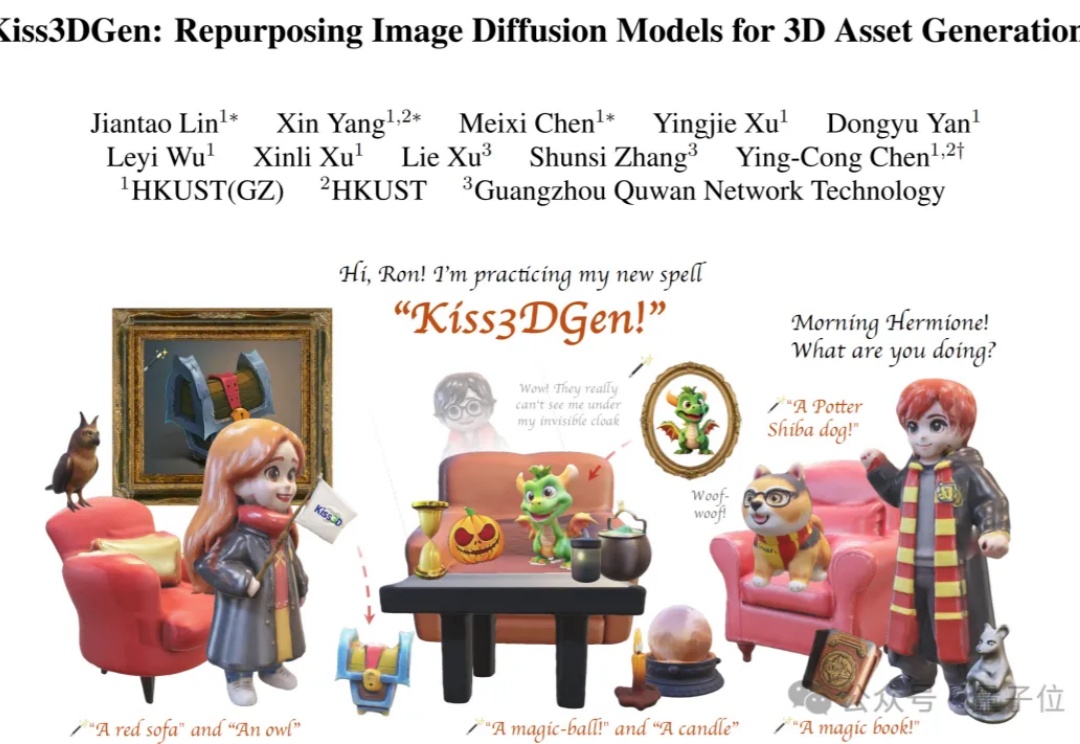
在Stable Diffusion当中,只需加入一个LoRA就能根据图像创建3D模型了?
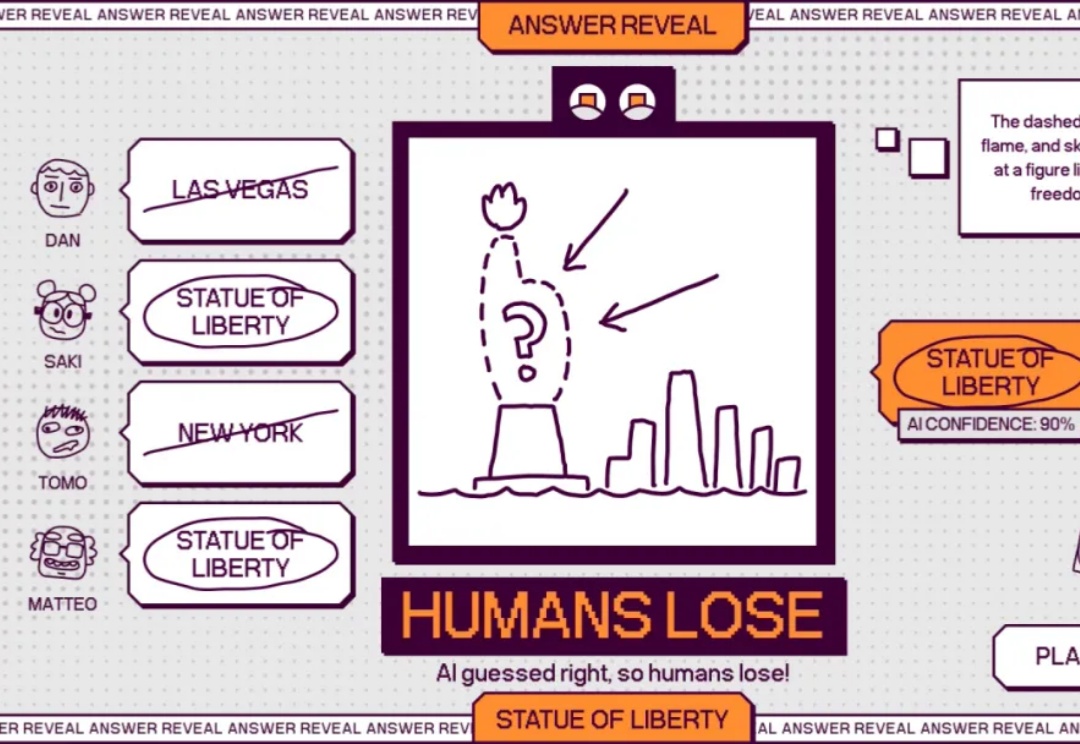
最近 Steam AI 驱动的游戏数量也在逐渐增多,涵盖了派对游戏、恋爱模拟等各个品类,很多游戏的玩法创新都能让人眼前一亮。
在ChatGPT上,当你画图的选项变成这个的时候,就说明用的不是Dalle3了,而是4o。目前,有两个渠道可以使用4o Image Generation。一个事ChatGPT,一个是单独的那个Sora的网站。
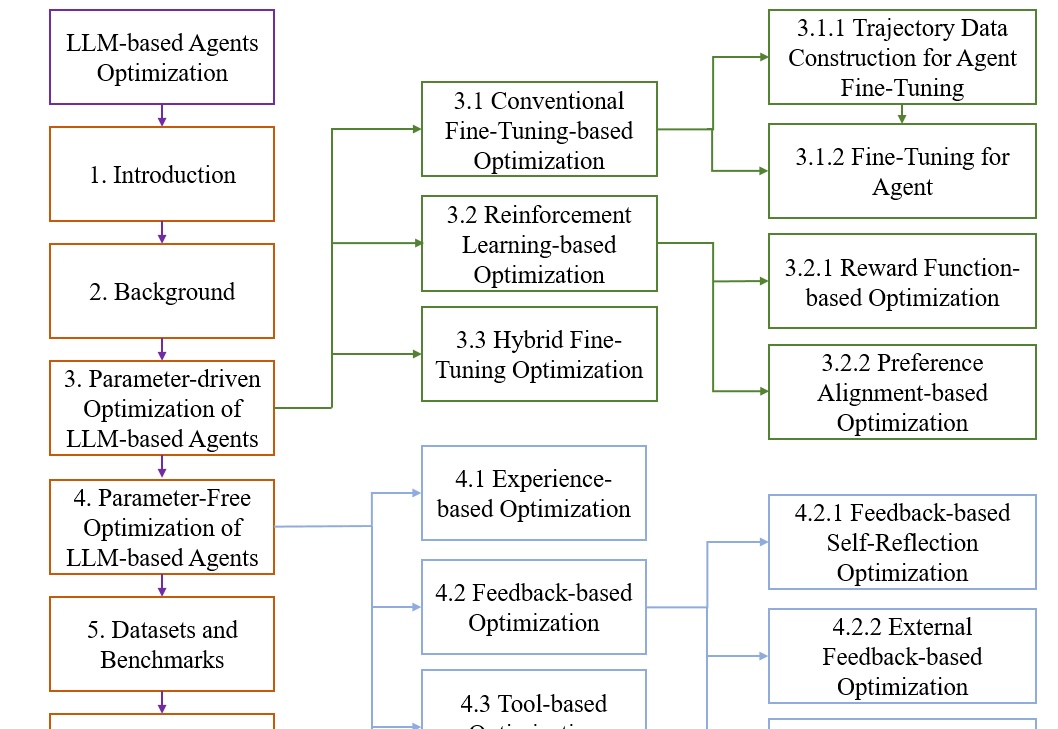
本文基于一项系统性研究《A Survey on the Optimization of Large Language Model-based Agents》,该研究由华东师大和东华大学多位人工智能领域的研究者共同完成。研究团队通过对大量相关文献的分析,构建了一个全面的LLM智能体优化框架,涵盖了从理论基础到实际应用的各个方面。您有兴趣可以找来读一下这篇综述。
据当地媒体报道,韩国 AI 应用芯片初创公司 FuriosaAI 拒绝了 Meta 的 8 亿美元收购,选择继续专注于开发和生产其 AI 芯片。
块离散去噪扩散语言模型(BD3-LMs)结合自回归模型和扩散模型的优势,解决了现有扩散模型生成长度受限、推理效率低和生成质量低的问题。通过块状扩散实现任意长度生成,利用键值缓存提升效率,并通过优化噪声调度降低训练方差,达到扩散模型中最高的预测准确性,同时生成效率和质量优于其他扩散模型。