Z Potentials|专访方寸跃迁李筱健、董胤蓬:安全没有终点,每完成一次九十九分的答卷,下一轮新的风险已经出现
Z Potentials|专访方寸跃迁李筱健、董胤蓬:安全没有终点,每完成一次九十九分的答卷,下一轮新的风险已经出现一次错误回答,可能只会让用户关掉页面;一次错误执行,却可能改写企业数据库、触发一笔交易,甚至让整条业务流程偏离轨道。
来自主题: AI资讯
9373 点击 2026-07-24 11:07

 搜索
一次错误回答,可能只会让用户关掉页面;一次错误执行,却可能改写企业数据库、触发一笔交易,甚至让整条业务流程偏离轨道。
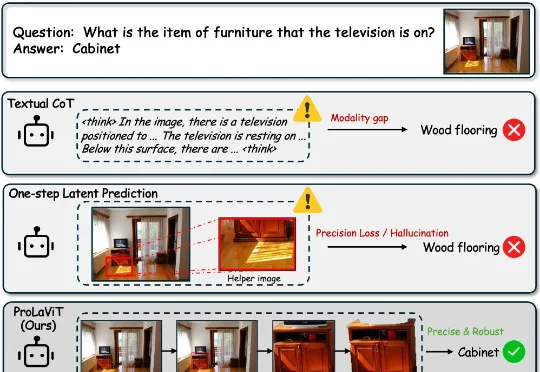
针对这一挑战,腾讯内容服务部 BAC 提出了一个名为 ProLaViT(Progressive Latent Visual Thought) 的全新框架。它的核心思想是:别急着下结论,先在连续隐空间里像人一样「步步推导」。 即让模型遵循 「定位 → 聚焦 → 分离」(Locate → Focus → Isolate) 的因果链,逐步收紧视觉注意力,最终精准锁定目标。
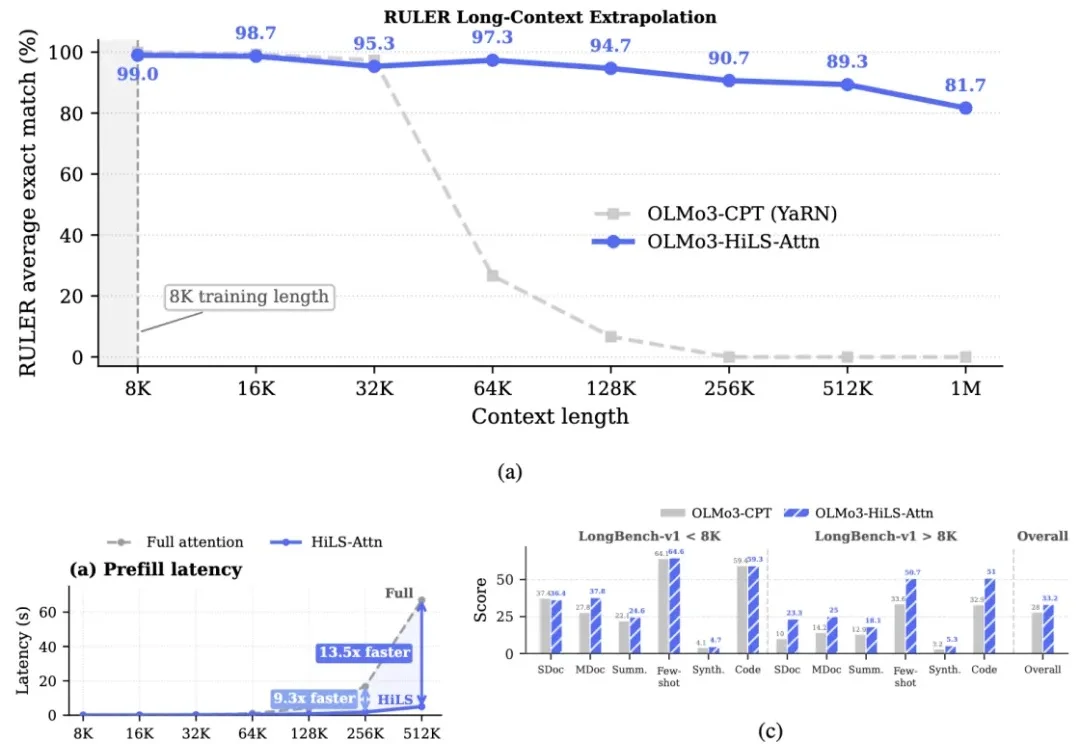
让大模型 "读得更长" 一直是 Agent、深度推理和海量资料整合等场景的刚需,但标准全注意力机制的计算量随序列长度呈平方级增长,始终是横亘在长上下文建模面前的三座大山。
Kimi K3 是一个 2.8 万亿参数模型,基于 KDA 混合线性注意力机制(Kimi Delta Attention)和注意力残差(Attention Residuals)技术构建,原生支持视觉理解,并拥有 100 万 token 上下文窗口。它是全球首个开源的 3 万亿级别模型,面向长程编程、知识工作和推理等前沿智能场景而设计。
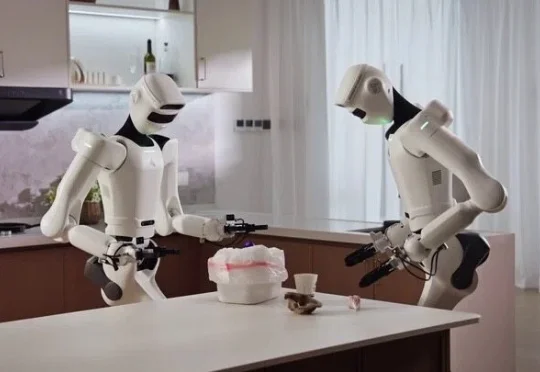
WAIC 前夕,星尘智能(Astribot)新模型 Lumo-2,直接在官网甩出 20 + 真机视频 ——这背后,是星尘智能发布的第二代具身基座模型,也是业内首个面向家庭场景的隐式世界 - 动作模型(Latent World-Action Model),同步发的,还智能体 Agent Philia。
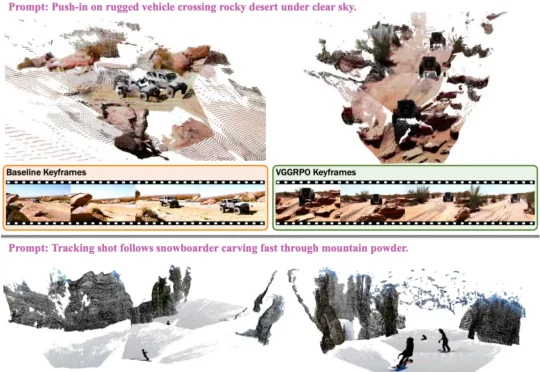
最近,来自 Google、哥本哈根大学、牛津大学等机构的研究者提出了 VGGRPO(Visual Geometry GRPO,收录于 ECCV 2026)。这项工作聚焦于一个核心问题:如何在不牺牲预训练模型泛化能力的前提下,高效地提升视频生成的几何一致性,并使其适用于动态场景。其核心思路是,在隐空间(latent space)中利用 4D 几何奖励,进行几何感知的视频后训练。
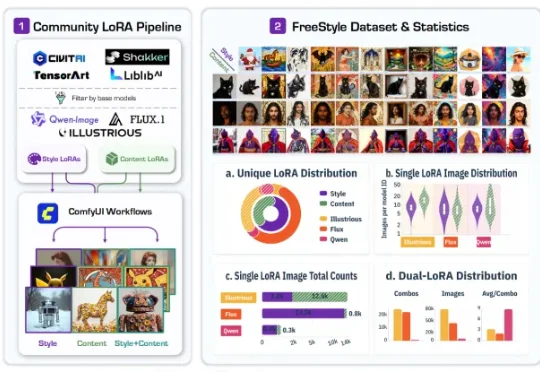
最近,一篇名为 FreeStyle: Free Control of Style-Content Dual-Reference Generation from Community LoRA Mining 的工作引起了不少关注。换句话说,FreeStyle 研究的是 style-content dual-reference generation,也就是「内容 - 风格双参考生成」。
Z Potentials获悉,近日,总部位于硅谷与新加坡的Prana Labs正式完成近千万美金种子轮融资,由元生资本、XVC、Creekstone、三七互娱联合投资,澜松资本担任独家财务顾问。 与赛
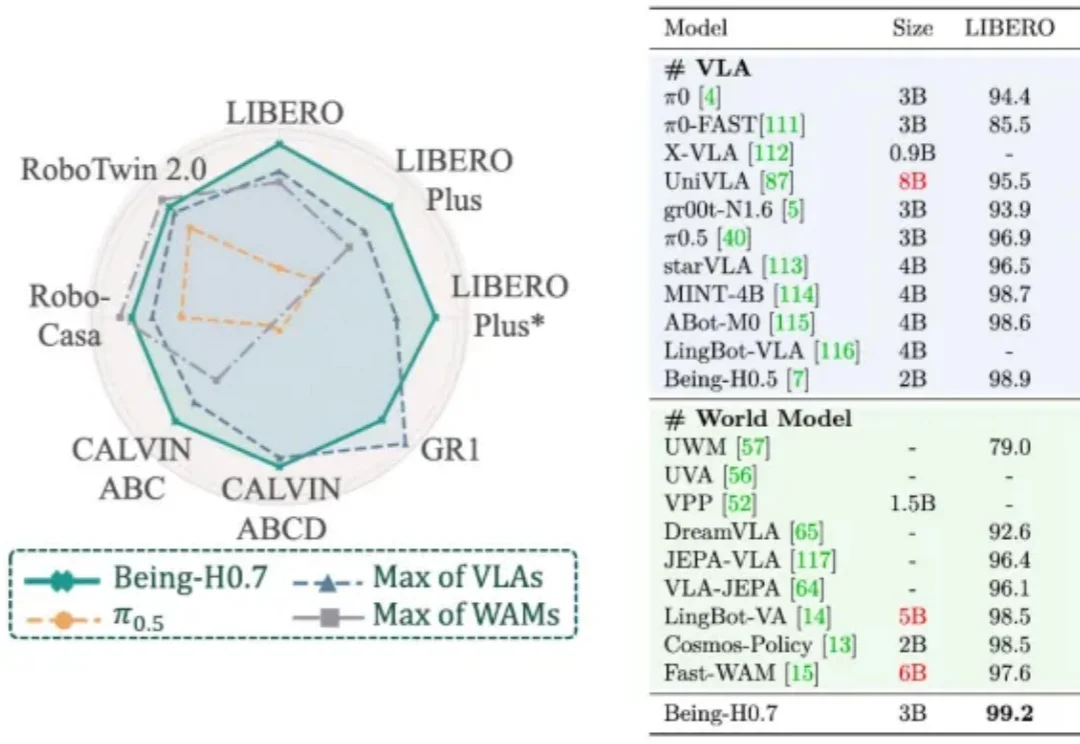
过去两年,人形机器人赛道的竞争焦点,正从整机硬件进一步延伸到模型能力。
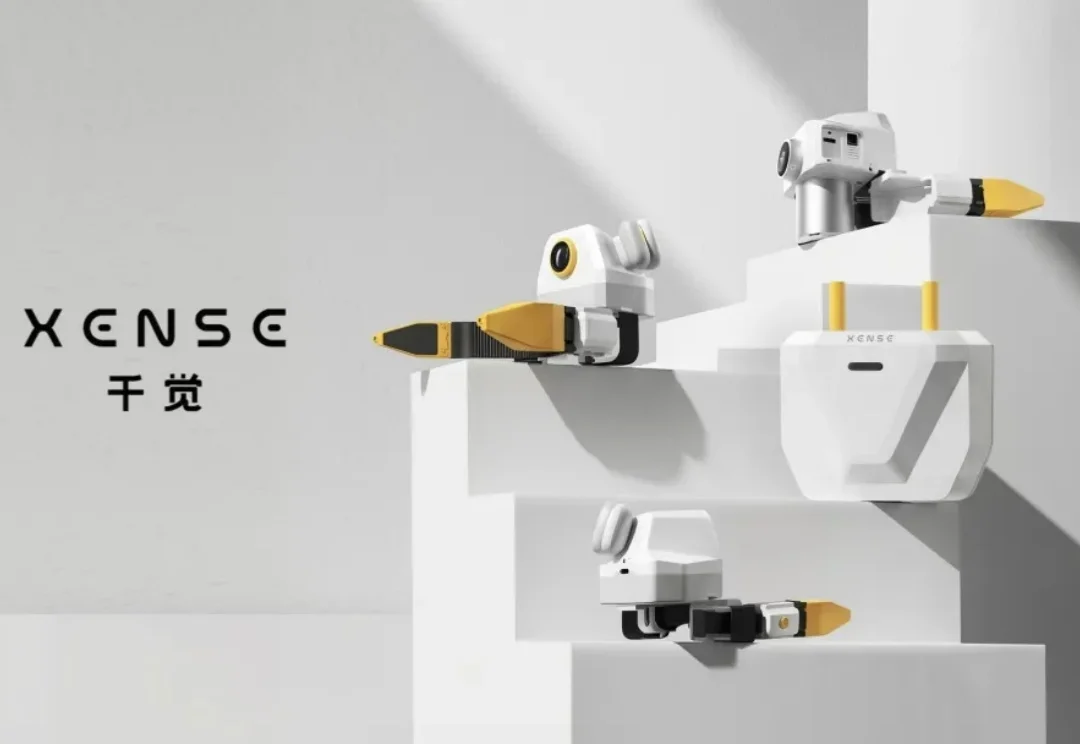
Z Potentials 获悉,近日,国内具身触觉头部企业千觉机器人科技(上海)有限公司(以下简称“千觉机器人”或“Xense Robotics”)完成亿元融资。本轮融资由顶级具身智能产业方与吉德电器战略投资,新锐投资机构天季资本共同投资。