详解“端到端”下一代模型VLA,通向自动驾驶的关键跳板
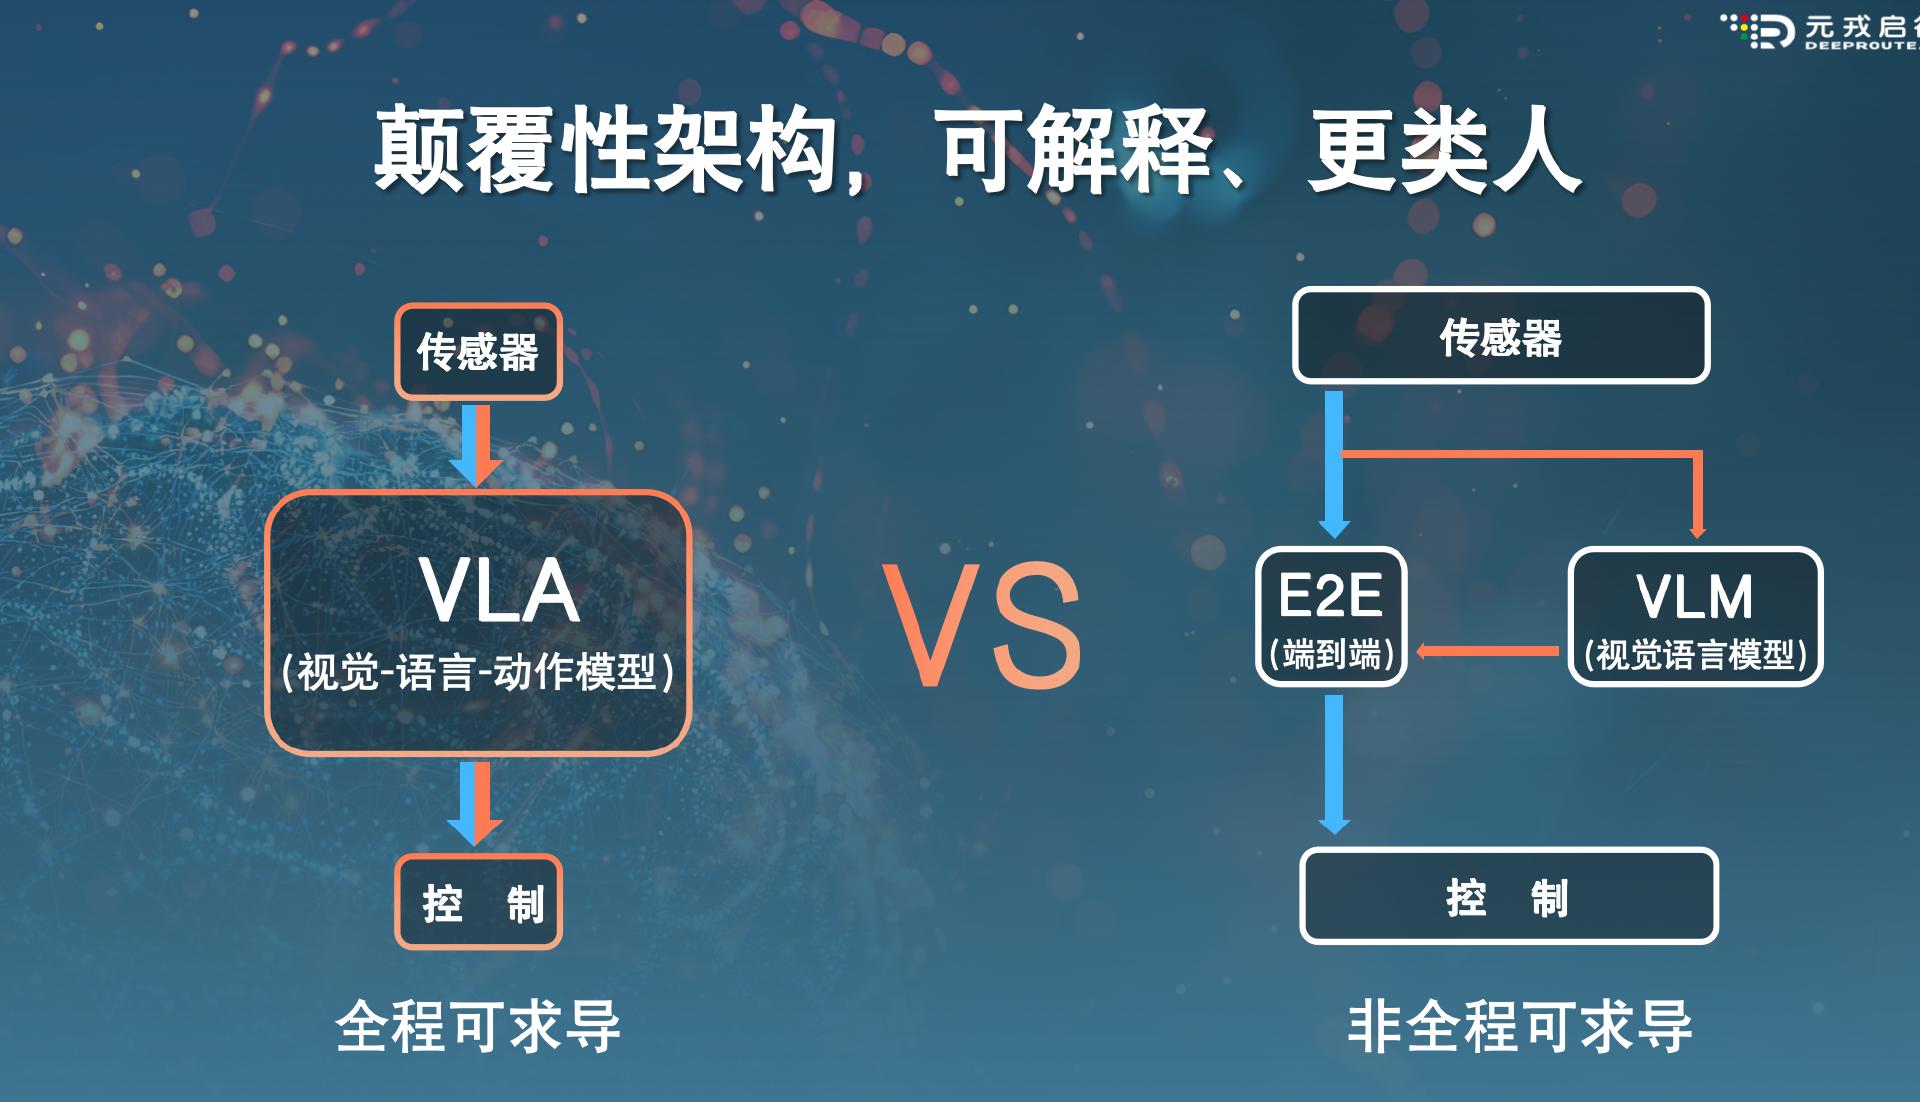
详解“端到端”下一代模型VLA,通向自动驾驶的关键跳板近期,智驾行业出现了一个融合了视觉、语言和动作的多模态大模型范式——VLA(Vision-Language-Action Model,即视觉-语言-动作模型),拥有更高的场景推理能力与泛化能力。不少智驾人士都将VLA视为当下“端到端”方案的2.0版本。
来自主题: AI资讯
7584 点击 2024-11-09 09:50

 搜索
近期,智驾行业出现了一个融合了视觉、语言和动作的多模态大模型范式——VLA(Vision-Language-Action Model,即视觉-语言-动作模型),拥有更高的场景推理能力与泛化能力。不少智驾人士都将VLA视为当下“端到端”方案的2.0版本。
计算机视觉(Computer Vision)的工作原理与人类视觉类似,但需要机器依靠摄像头、数据和算法在很短的时间内完成任务。
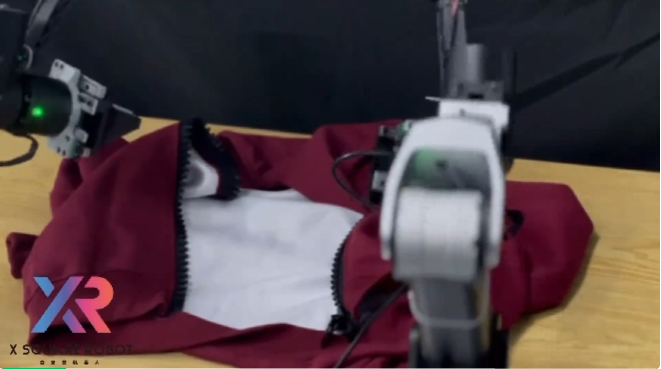
近日,关于 Open AI 被投企业 Physical Intelligence (PI) 的一系列报道,让人们关注到具身智能大模型引发的机器人时代变革。
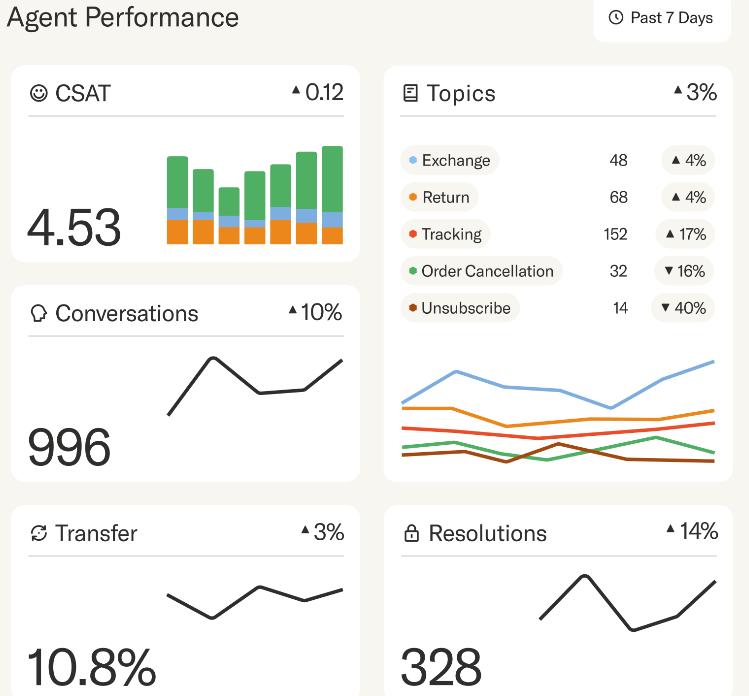
AI客服的潜力,比我们想象得都还要大。 近期,AI客服头部Sierra刚刚完成一轮1.75亿美元的融资,投后估值攀升至45亿美元。

机器人AI大脑成具身智能热门赛道
近日,中科大王杰教授团队(MIRA Lab)和华为诺亚方舟实验室(Huawei Noah's Ark Lab)联合提出了可生成具有成千上万节点规模的神经电路生成与优化框架,具备高扩展性和高可解释性,这为新一代芯片电路逻辑综合工具奠定了重要基础。论文发表在 CCF-A 类人工智能顶级会议 Neural Information Processing Systems(NeurIPS 2024)。

钛媒体App 11月5日消息,利用AI技术帮机器人造“大脑”的美国独角兽公司物理智能(Physical Intelligence)宣布完成4亿美元(约合人民币28.39亿元)融资。
NVIDIA DGX GB200 超级计算集群数据中心部署指南解读,NVIDIA AI 工厂部署与 Broadcom AI 计算 ASIC 光学连接技术

只要一个3B参数的大模型,就能控制机器人,帮你搞定各种家务。 叠衣服冲咖啡都能轻松拿捏,而且全都是由模型自主控制,不需要遥控。 关键是,这还是个通用型的机器人控制模型,不同种类的机器人都能“通吃”。
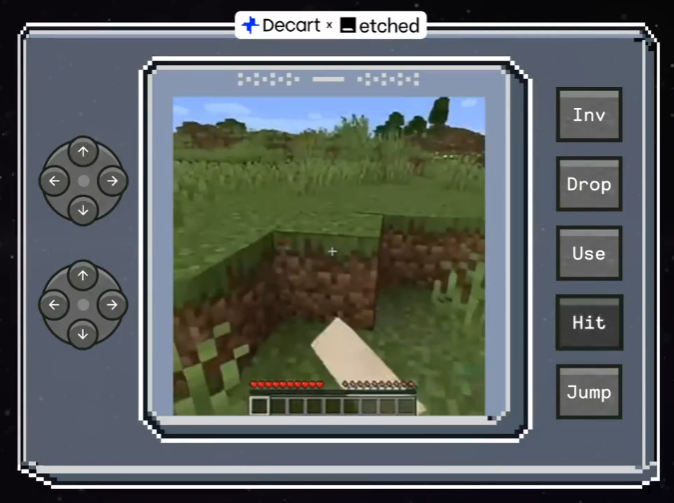
现在,一个大模型就能直接拿来当游戏,还是开放世界的那种! 可以直接根据玩家操作预测下一帧,连游戏引擎都省了。 这个怎么看都像是《我的世界》的界面,就是这款游戏Oasis本尊了。