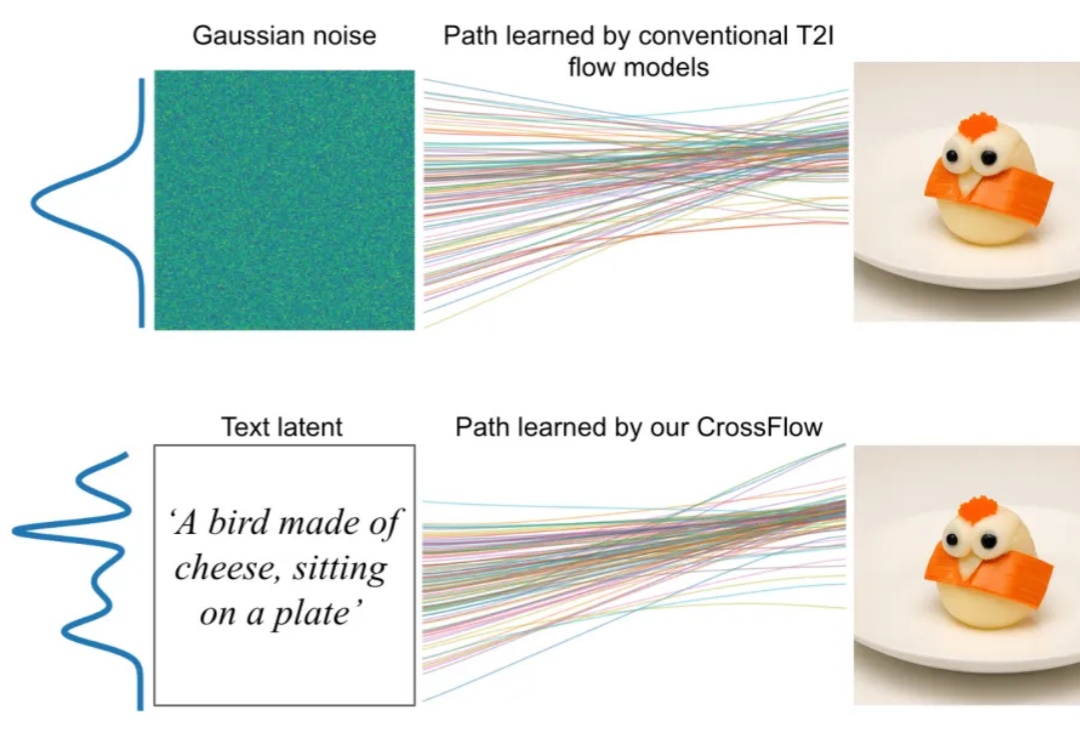
Meta新突破!跨模态生成告别噪声:流匹配实现任意模态无缝流转
Meta新突破!跨模态生成告别噪声:流匹配实现任意模态无缝流转在人工智能领域,跨模态生成(如文本到图像、图像到文本)一直是技术发展的前沿方向。现有方法如扩散模型(Diffusion Models)和流匹配(Flow Matching)虽取得了显著进展,但仍面临依赖噪声分布、复杂条件机制等挑战。
来自主题: AI技术研报
9700 点击 2025-06-04 14:18

 搜索
在人工智能领域,跨模态生成(如文本到图像、图像到文本)一直是技术发展的前沿方向。现有方法如扩散模型(Diffusion Models)和流匹配(Flow Matching)虽取得了显著进展,但仍面临依赖噪声分布、复杂条件机制等挑战。
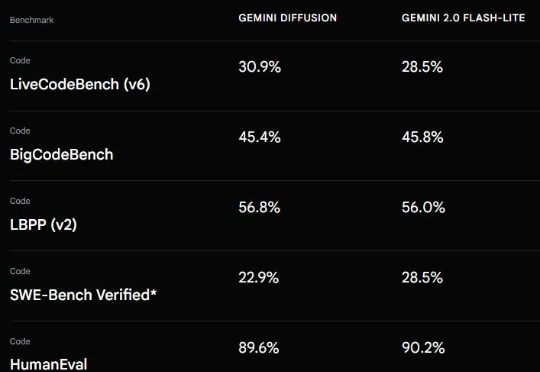
上个月 21 号,Google I/O 2025 开发者大会可说是吸睛无数,各种 AI 模型、技术、工具、服务、应用让人目不暇接。在这其中,Gemini Diffusion 绝对算是最让人兴奋的进步之一。从名字看得出来,这是一个采用了扩散模型的 AI 模型,而这个模型却并非我们通常看到的扩散式视觉生成模型,而是一个地地道道的语言模型!
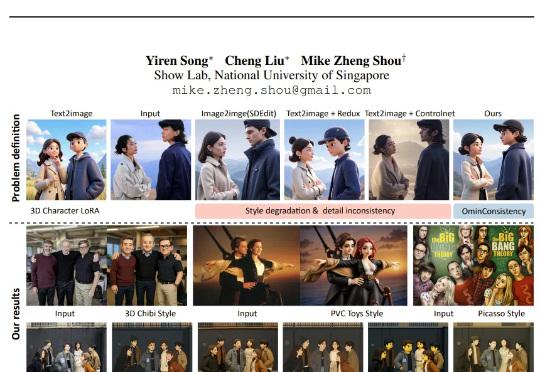
不久前,GPT-4o 的最新图像风格化与编辑能力横空出世,用吉卜力等风格生成的效果令人惊艳,也让我们清晰看到了开源社区与商业 API 在图像风格化一致性上的巨大差距。

每天宣扬「AI变革」的外媒Business Insider,终于看到这把屠龙刀落在了自己头上。刚刚,CEO宣布:裁员21%,全面拥抱AI!讽刺吗?那些亲手写下「AI将颠覆媒体」的记者们,正被AI亲手送下了楼。工会怒斥:这是对新闻的背叛,是对人类记者尊严的公然践踏!更可怕的是,今天是他们,明天会不会轮到你?
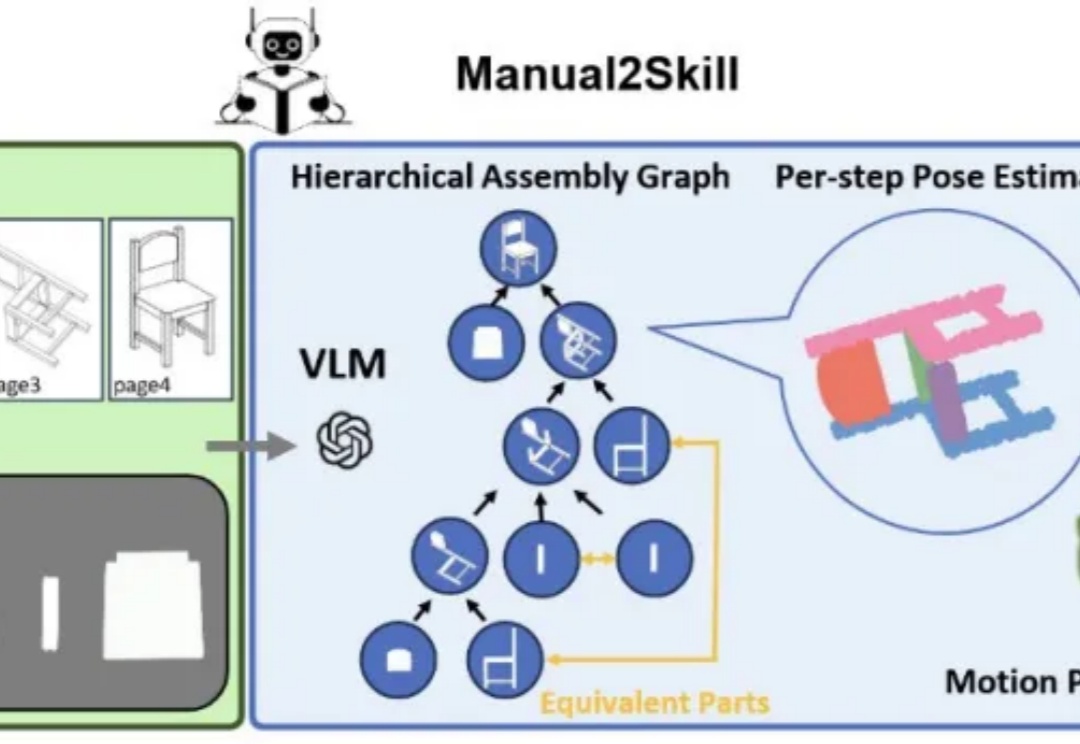
视觉语言模型(Vision-Language Models, VLMs),为真实环境中的机器人操作任务提供了极具潜力的解决方案。
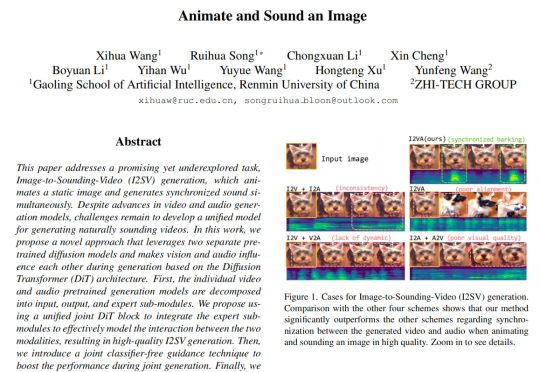
来自中国人民大学高瓴人工智能学院与值得买科技 AI 团队在 CVPR 2025 会议上发表了一项新工作,首次提出了一种从静态图像直接生成同步音视频内容的生成框架。其核心设计 JointDiT(Joint Diffusion Transformer)框架实现了图像 → 动态视频 + 声音的高质量联合生成。

想象一下,作为销售经理,你每天晚上都会被一个问题困扰:我的销售代表今天在客户家里到底说了什么?这不是什么玄学,而是销售行业一个长期存在的盲区。我们有监控后台操作的工具,有分析线上会议的软件,甚至有追踪每个电话的系统,但对于面对面销售这个最关键的环节,我们却一直处在黑暗中摸索。
从OpenAI 的 4o 到 Stable Diffusion,能够根据文本提示生成逼真图像的 AI 基础模型如今已比比皆是。相比之下,能够仅凭文本提示就生成完整、连贯的 3D 在线环境的基础模型才刚刚崭露头角。
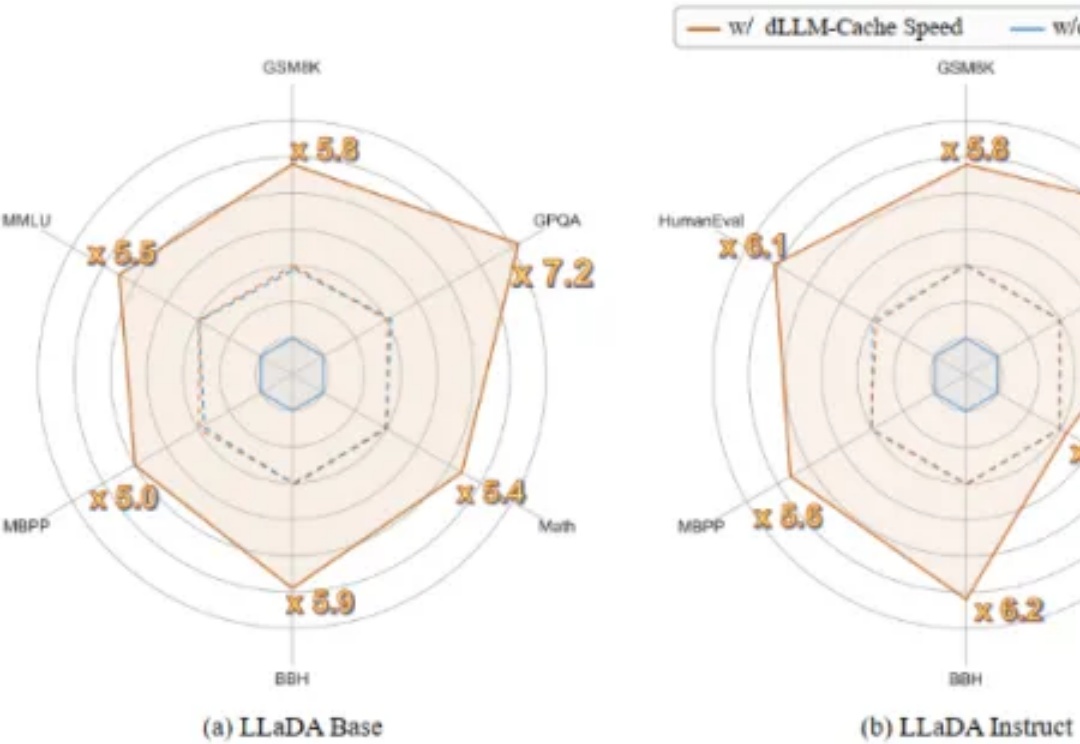
首个用于加速扩散式大语言模型(diffusion-based Large Language Models, 简称 dLLMs)推理过程的免训练方法。

作为首批入选印度“IndiaAI Mission”国家级项目、承担构建印度主权基础大模型任务的公司之一,Sarvam AI 近日发布了名为 Sarvam-M 的模型。这是一个基于 Mistral Small 构建的 240 亿参数、权重开放的混合语言模型。