机器人高层指挥低层做,“坐标系转移接口”一次演示实现泛化学习 | ICML2025
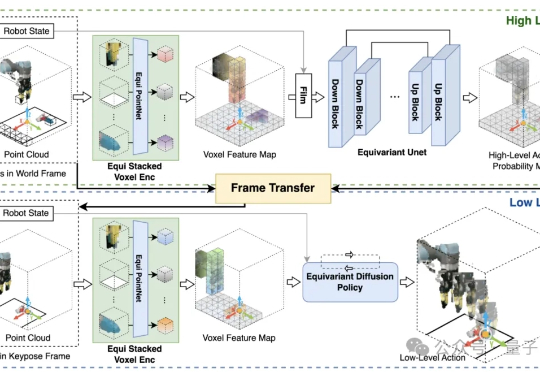
机器人高层指挥低层做,“坐标系转移接口”一次演示实现泛化学习 | ICML2025如何让AI像人一样,仅凭少量演示,就能稳健适应复杂多变的真实场景? 美国东北大学和波士顿动力RAI提出了HEP(Hierarchical Equivariant Policy via Frame Transfer)框架,首创“坐标系转移接口”,让机器人学习更高效、泛化更灵活。
搜索
如何让AI像人一样,仅凭少量演示,就能稳健适应复杂多变的真实场景? 美国东北大学和波士顿动力RAI提出了HEP(Hierarchical Equivariant Policy via Frame Transfer)框架,首创“坐标系转移接口”,让机器人学习更高效、泛化更灵活。
据外媒7月11日报道,该平台采用了Paradox.ai开发的AI聊天机器人“Olivia”(奥利维亚),用于收集求职者的个人信息,包括姓名、电话、邮箱、住址等敏感数据。然而,平台的安全防护存在严重缺陷。
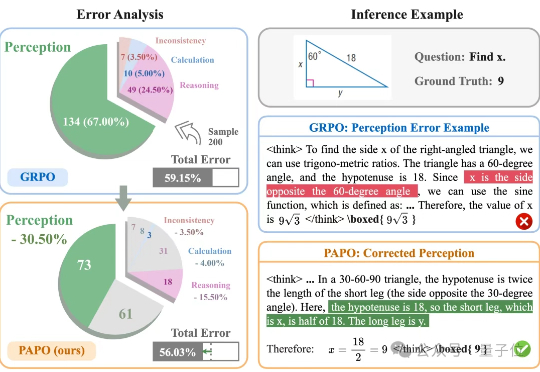
让大模型在学习推理的同时学会感知。伊利诺伊大学香槟分校(UIUC)与阿里巴巴通义实验室联合推出了全新的专注于多模态推理的强化学习算法PAPO(Perception-Aware Policy Optimization)。
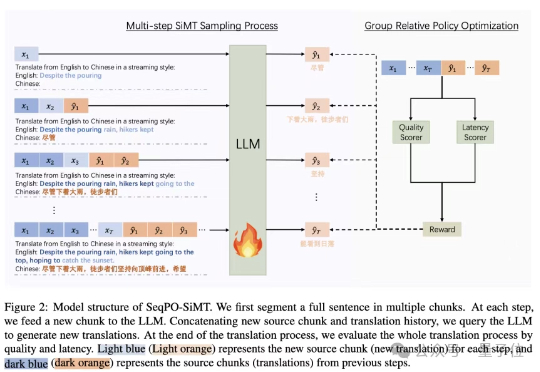
为此,香港中文大学、字节跳动Seed和斯坦福大学研究团队出手,提出了一种面向同声传译的序贯策略优化框架 (Sequential Policy Optimization for Simultaneous Machine Translation, SeqPO-SiMT)。
当前,强化学习(RL)在提升大语言模型(LLM)推理能力方面展现出巨大潜力。DeepSeek R1、Kimi K1.5 和 Qwen 3 等模型充分证明了 RL 在增强 LLM 复杂推理能力方面的有效性。
近日,腾讯 PCG 社交线的研究团队针对这一问题,采用强化学习(RL)训练方法,通过分组相对策略优化(Group Relative Policy Optimization, GRPO)算法,结合基于奖励的课程采样策略(Reward-based Curriculum Sampling, RCS),将其创新性地应用在意图识别任务上,
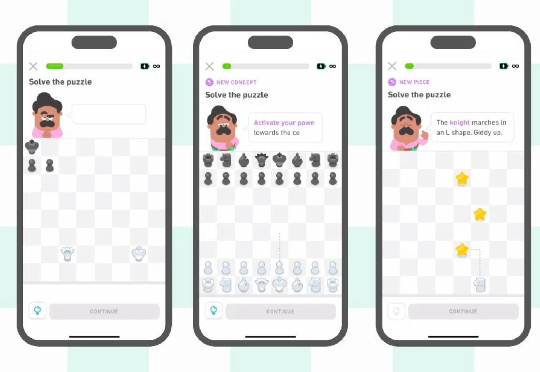
近日,非凡产研完成了对全球范围内规模以上AI 教育应用的产品收录,共计 88 款。它们的收入情况如何?根据非凡产研数据,全球AI教育App单月营收最大的依然是多邻国(Duolingo),单月破2亿元;而中国教育AI App,收入排行第一的是作业帮旗下出海产品 Question AI。
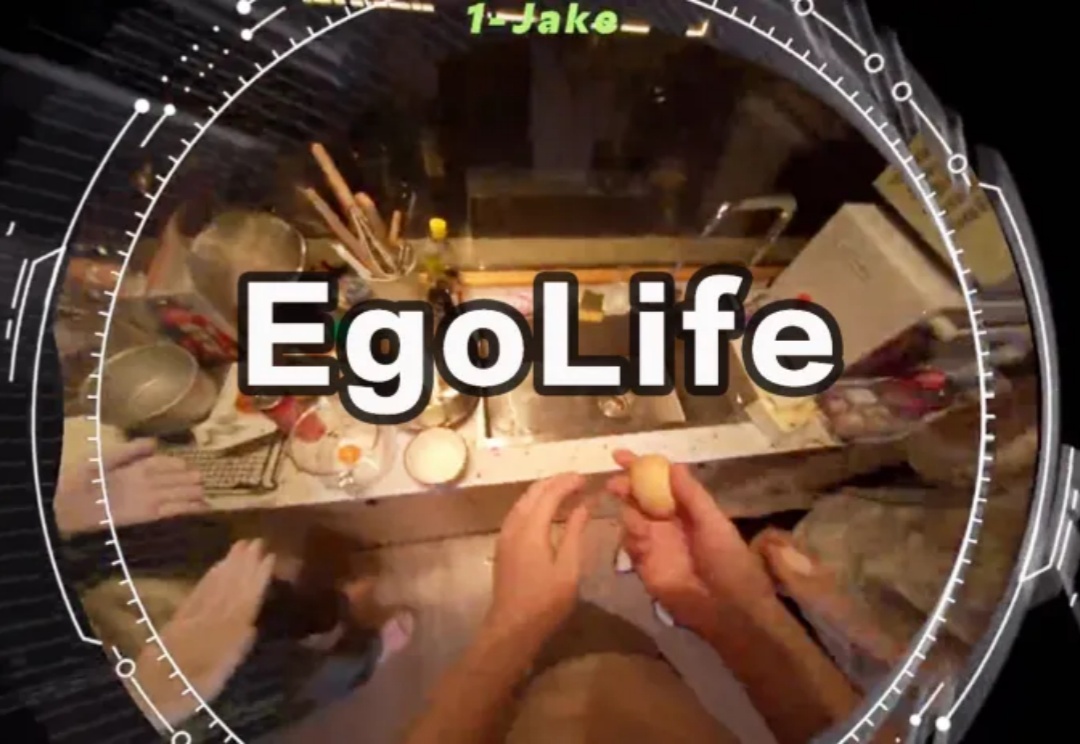
通过收集六名志愿者一周的多模态生活数据,研究人员构建了300小时的第一视角数据集EgoLife,旨在开发一款基于智能眼镜的AI生活助手。项目提出了EgoButler系统,包含EgoGPT和EgoRAG两个模块,分别用于视频理解与长时记忆问答,助力AI深入理解日常生活并提供个性化帮助。
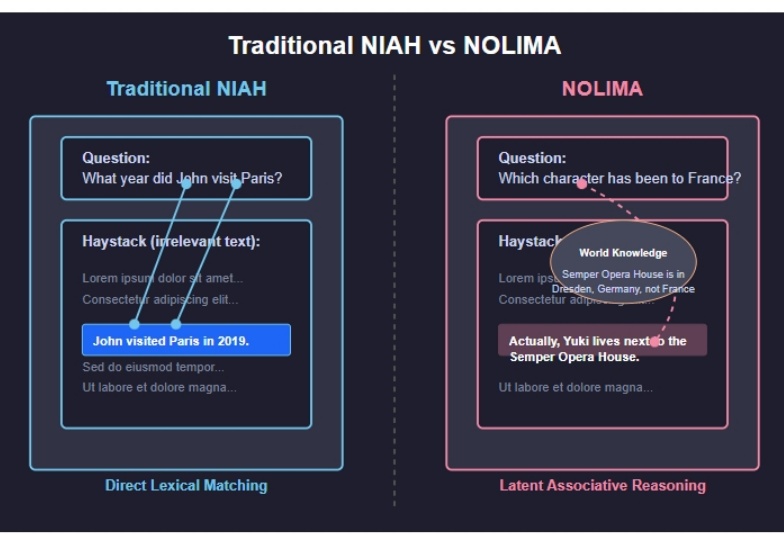
2025 年 2 月发布的 NoLiMA 是一种大语言模型(LLM)长文本理解能力评估方法。不同于传统“大海捞针”(Needle-in-a-Haystack, NIAH)测试依赖关键词匹配的做法,它最大的特点是 通过精心设计问题和关键信息,迫使模型进行深层语义理解和推理,才能从长文本中找到答案。
GRPO(Group Relative Policy Optimization)是 DeepSeek-R1 成功的基础技术之一,我们之前也多次报道过该技术,比如《DeepSeek 用的 GRPO 占用大量内存?有人给出了些破解方法》。