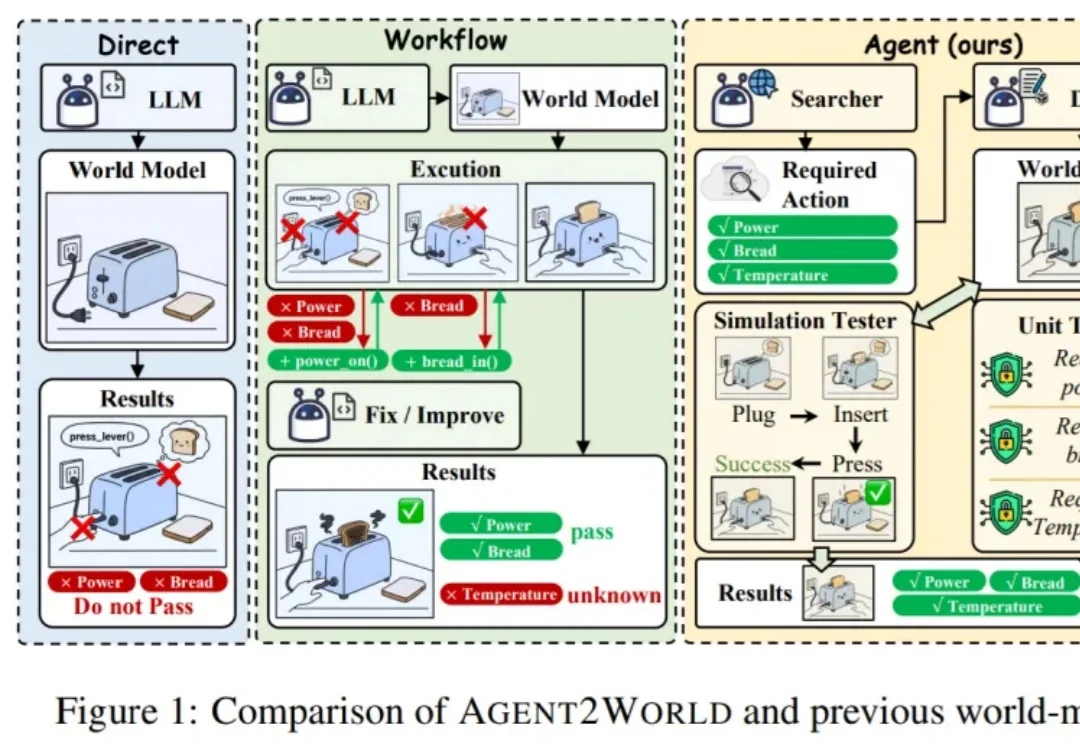
像开发软件一样造世界,Agent2World来了,把世界模型做成可运行的符号环境
像开发软件一样造世界,Agent2World来了,把世界模型做成可运行的符号环境让模型真正 “能行动”,往往需要一个可执行、可验证的符号世界模型(Symbolic World Model):它不是抽象的文字描述,而是能被规划器或执行器直接调用的形式化定义 —— 例如 PDDL 领域 / 问题,或可运行的环境代码 / 模拟器。
来自主题: AI技术研报
8108 点击 2026-02-03 09:11

 搜索
让模型真正 “能行动”,往往需要一个可执行、可验证的符号世界模型(Symbolic World Model):它不是抽象的文字描述,而是能被规划器或执行器直接调用的形式化定义 —— 例如 PDDL 领域 / 问题,或可运行的环境代码 / 模拟器。
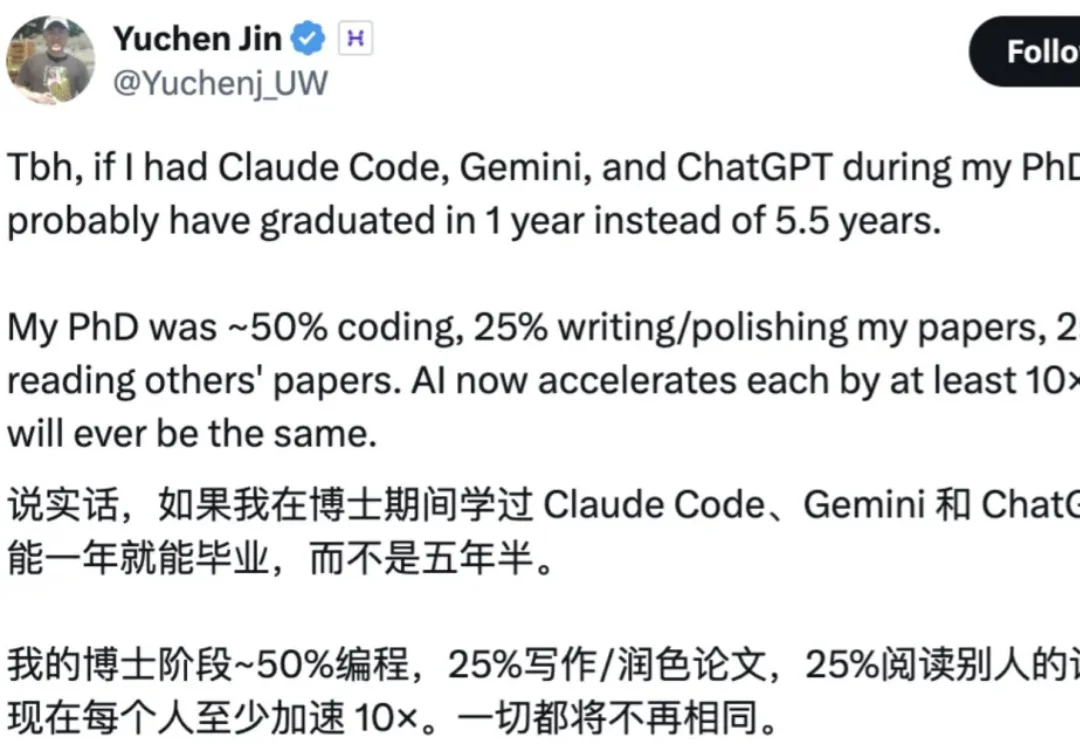
近日,X 知名博主、Hyperbolic 联创 & CEO Yuchen Jin 发帖称,如果在他读博士的时候就有 Claude Code、Gemini 和 ChatGPT 等各类 AI 工具出现,那么也许只要一年就能毕业,而不是用了 5.5 年。
让我们细数一下这两年令人印象深刻的模型代号:草莓、香蕉、胡萝卜……每次一亮相,总要和水果蔬菜沾点关系。最新的主角叫:Olive Oil Cake(橄榄油蛋糕),另加 Chestnut and Hazelnut(栗子和榛子)。

先说一句最关键的。十月,ChatPlayground.ai 的月访问量估算为25万上下,环比暴涨六倍多,具体是 611.53%。这个数据来自 Toolify 的十月增长榜。
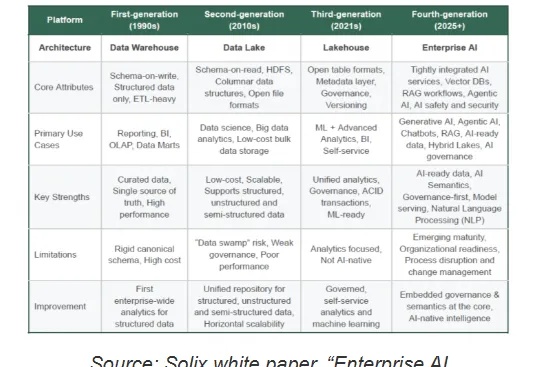
Solix Technologies最近推出了企业AI,据称这是业界首个第四代数据平台。Solix表示,通过将先进的数据管理功能集成到单一平台中,它可以提供企业成功利用AI所需的干净、可信和受治理的数据。
今天要讲的On-Policy Distillation(同策略/在线策略蒸馏)。这是一个Thinking Machines整的新活,这个新策略既有强化学习等在线策略方法的相关性和可靠性;又具备离线策略(Off-policy)方法的数据效率。
刚刚,不发论文、爱发博客的 Thinking Machines Lab (以下简称 TML)再次更新,发布了一篇题为《在策略蒸馏》的博客。在策略蒸馏(on-policy distillation)是一种将强化学习 (RL) 的纠错相关性与 SFT 的奖励密度相结合的训练方法。在将其用于数学推理和内部聊天助手时,TML 发现在策略蒸馏可以极低的成本超越其他方法。
年初的 DeepSeek-R1,带来了大模型强化学习(RL)的火爆。无论是数学推理、工具调用,还是多智能体协作,GRPO(Group Relative Policy Optimization)都成了最常见的 RL 算法。
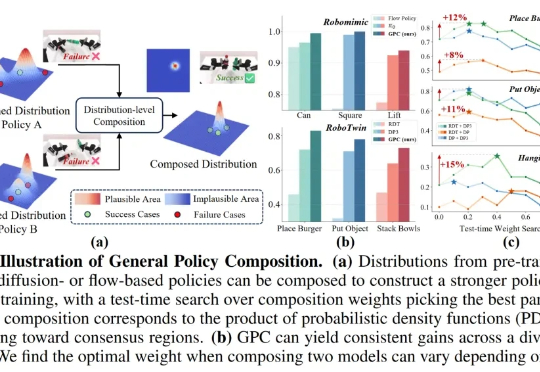
在机器人学习领域,提升基于生成式模型的控制策略(Policy)的性能通常意味着投入巨额成本进行额外的数据采集和模型训练,这极大地限制了机器人能力的快速迭代与升级。面对模型性能的瓶颈,如何在不增加训练负担的情况下,进一步挖掘并增强现有策略的潜力?
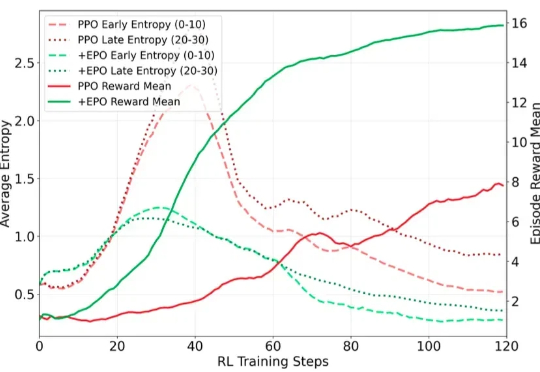
在训练多轮 LLM Agent 时(如需要 30 + 步交互才能完成单个任务的场景),研究者遇到了一个严重的训练不稳定问题:标准的强化学习方法(PPO/GRPO)在稀疏奖励环境下表现出剧烈的熵值震荡,导致训练曲线几乎不收敛。