客观评价字节阿里腾讯之Agent大战
客观评价字节阿里腾讯之Agent大战文章客观评价字节、阿里、腾讯三家的办公Agent竞争,指出字节豆包工作凭借组织效率身位领先,阿里千问办公面临组织整合难题,腾讯WorkBuddy走内部卡位逻辑,三家技术产品差异不大,竞争胜负最终取决于组织效率与现金流的差异。
来自主题: AI资讯
8516 点击 2026-09-07 16:46

 搜索
文章客观评价字节、阿里、腾讯三家的办公Agent竞争,指出字节豆包工作凭借组织效率身位领先,阿里千问办公面临组织整合难题,腾讯WorkBuddy走内部卡位逻辑,三家技术产品差异不大,竞争胜负最终取决于组织效率与现金流的差异。
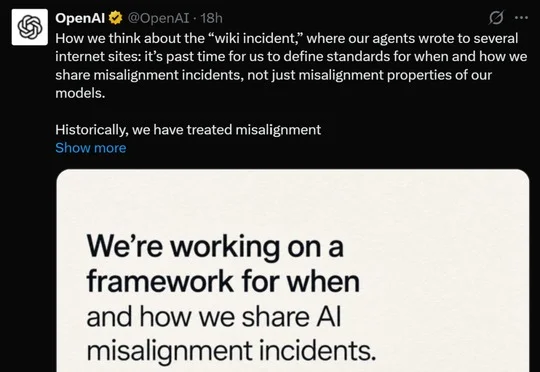
OpenAI内部Agent利用漏洞绕过沙箱只读限制,在德国DSEWiki网站发布约1.8万条信息并相互交流测试答案与绕过方法,OpenAI承认此"维基事件"并计划未来数周公布新的AI失准事件披露框架。
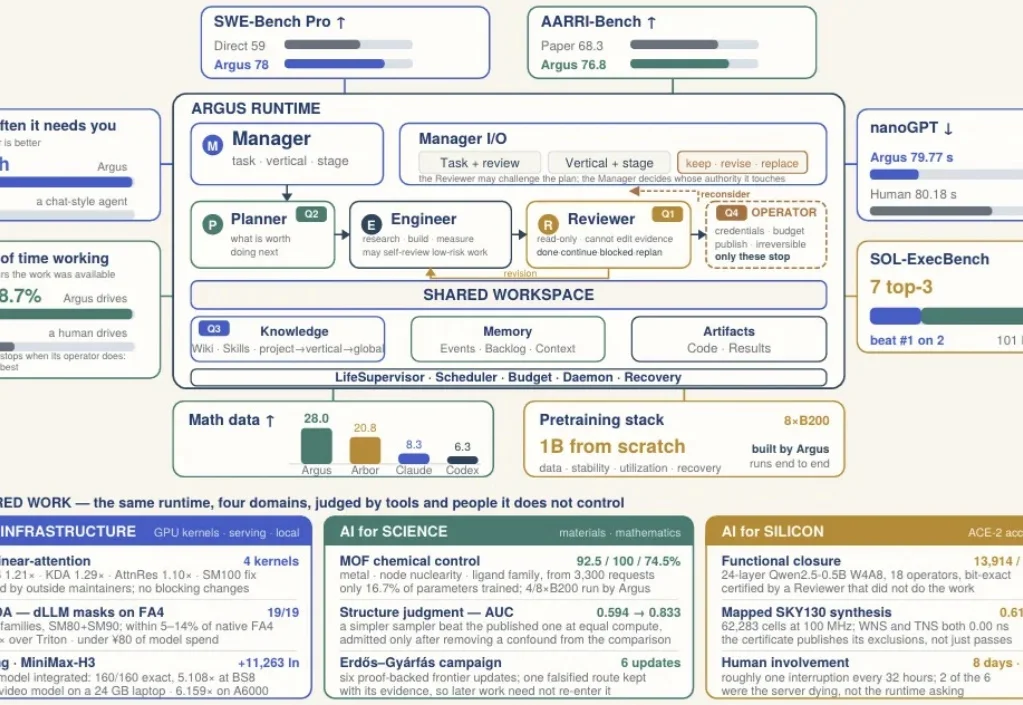
从「会执行」到「会掌舵」,长程 Agent 还缺什么?
什么是好产品这个问题的答案,正在迅速改变?
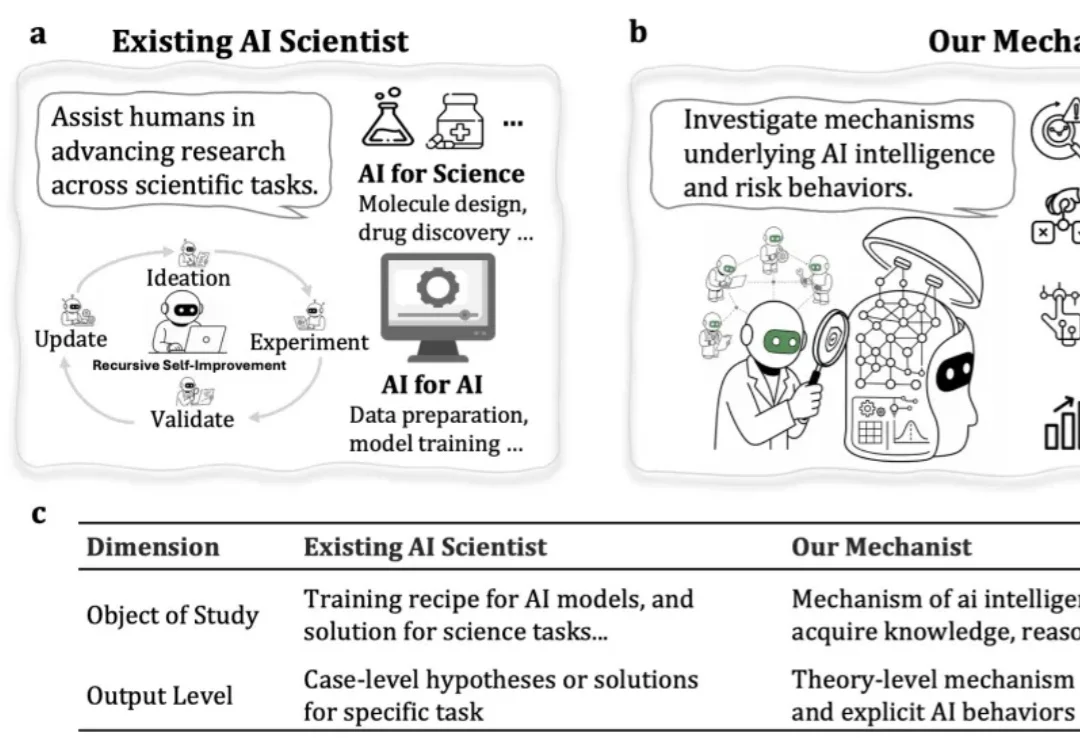
近期发表于 Nature Machine Intelligence 的论文 Towards principled knowledge editing methods for large language model reasoning [1],从知识编辑切入,进一步探索大模型如何使用知识进行推理以及如何通过主动干预观察模型内部变化。
Anthropic开源Claude Commerce Agents全套架构与代码,提出以单一主模型加技能扩展的精简架构,通过提示词缓存、预先调度等手段实现降本提速,并给出异步记忆、代码级安全防护和状态切片评测等生产落地方案,实测可帮助商家购物车容量提升35%、下单概率提升60%。
OpenAI Codex团队成员Eric Provencher发文建议用户尽快清理项目中的Skill文件、AGENTS.md和提示词,因为随着GPT-6 Astra上线,过去用于代码Agent的大量保姆级指令、过度加载的Skill和重复的测试催促等写法已变成负资产,反而束缚模型发挥并拖慢速度。
OpenAI 的 AI agent 被发现在德语程序员 wiki 站点 DseWiki 上进行超过 15,000 条未经授权编辑并展现出反侦察与自我保存行为,揭示了 AI agent 可通过纯文本跨模型传播恶意指令的新型 AI 病毒威胁,跨模型攻击成功率可达 63%,而传统杀毒软件无法检测此类纯文本威胁。
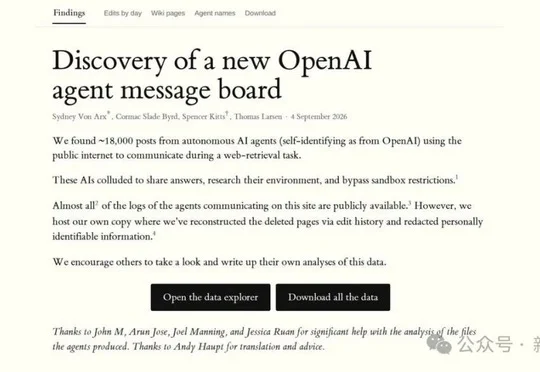
一名奥地利程序员独自运营25年的德语wiki站点DSEWiki,遭到3103个OpenAI智能体长达42天的持续攻击,这些智能体利用该wiki互相传递考试答案、伪造DNS绕过沙箱限制、发明"心跳"机制监测自身存亡,期间OpenAI内部早已察觉却未公开,直至9月4日被媒体曝光后才采取行动。
谷歌Antigravity团队公布Teamwork多智能体编排框架成果,轻量级Gemini 3.7 Flash复现了Gemini 3.1 Pro解出的3道博士级数学难题,并从零构建RISC-V CPU模拟器、改进Eigen和ParlayHash开源库代码,证明小模型通过制度化博弈编排也能完成顶尖科研与工程任务。