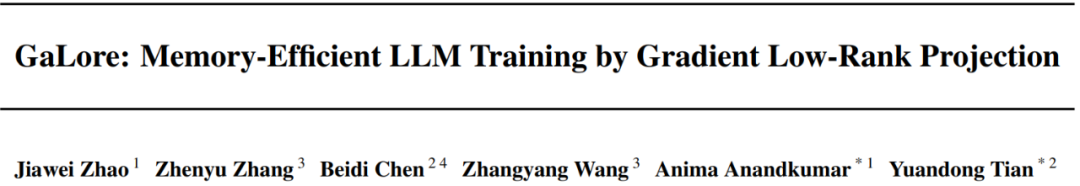
田渊栋等人新作:突破内存瓶颈,让一块4090预训练7B大模型
田渊栋等人新作:突破内存瓶颈,让一块4090预训练7B大模型3 月 6 日,田渊栋又一项研究出炉,这次,他们主攻 LLM 内存效率。除了田渊栋本人,还有来自加州理工学院、德克萨斯大学奥斯汀分校以及 CMU 的研究者。
来自主题: AI技术研报
12117 点击 2024-03-08 15:07

 搜索
3 月 6 日,田渊栋又一项研究出炉,这次,他们主攻 LLM 内存效率。除了田渊栋本人,还有来自加州理工学院、德克萨斯大学奥斯汀分校以及 CMU 的研究者。

参照SuperCLUE(中文通用大模型综合性测评基准)框架专门定制了1000道题目集,一一测试了ChatGPT4、 智谱chatGLM-4、Baichuan2-Turbo、百度ERNIE-Bot 4.0、Yi-34B-chat、llama 2等模型在保险业务上的表现。
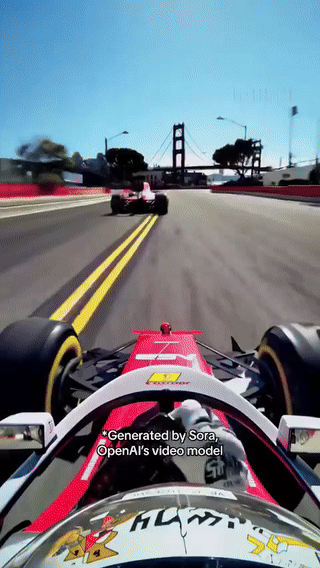
最近一段时间,AI 与大模型技术突飞猛进。春节刚过,前沿方向上就迎来了新一轮突破。

OpenAI这家AI初创公司,是历史上增长最快的公司之一,但它商业模式的长期可行性,仍然存在疑问。烧光现金流之前,OpenAI能交出怎样答卷?

2024年2月23日,OpenAI、微软、贝佐斯风投、英伟达等总计18位投资公司向一家机器人公司注资了6.75亿美元,这家公司就是Figure AI。

近期,清华大学和哈尔滨工业大学联合发布了一篇论文:把大模型压缩到 1.0073 个比特时,仍然能使其保持约 83% 的性能!
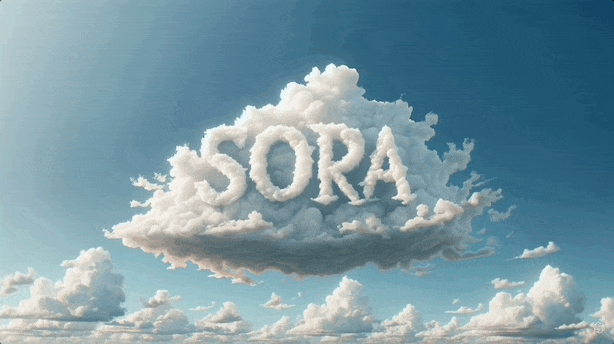
Sora刚发布不久,就被逆向工程“解剖”了?!

黄院士在《赛博朋克2077》里搞的智能NPC,已经飙起中文了?
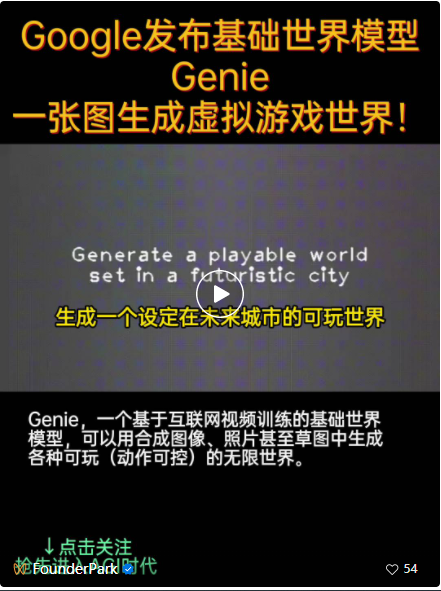
Google 最近在大模型上动作不断,先是发布了性能更强大的多模态 Gemini 1.5 Pro,然后是开源的小模型 Gemma,评测结果超过了 7b 量级的 Llama 2。

自曝996作息的OpenAI研究员Jason Wei表示,Sora代表着视频生成的GPT-2时刻。竞争的关键,就是算力和数据了。国内有可能成功「复刻」Sora吗?华人团队的这份37页技术报告,或许能给我们一些启发。