
CVPR 2025:长Prompt对齐问题也能评估了!当前最大AIGC评估数据集,模型评分超越当前SOTA
CVPR 2025:长Prompt对齐问题也能评估了!当前最大AIGC评估数据集,模型评分超越当前SOTA今年,CVPR共有13008份有效投稿并进入评审流程,其中2878篇被录用,最终录用率为22.1%。
来自主题: AI技术研报
9283 点击 2025-03-15 14:50

 搜索
今年,CVPR共有13008份有效投稿并进入评审流程,其中2878篇被录用,最终录用率为22.1%。
30天学会编程、7天AI入门、40分钟教会你如何使用DeepSeek!不要998、不要88,现在只要9.8就能轻松入门!对于这些宣传语,相信很多人都不会陌生。每一次有新的技术和商业风口出现时,相关的网络课程就会从四面八方出现,以各种方式完成收割。
现在是 2025 年,新论文要以博客形式出现。

融资7个月未果,一家AI创企选择卖身。

干掉英特尔之后,苏妈又向英伟达发起猛攻!最新发布的48G两款GPU基准测试,AI性能相较4090飙升7.3倍。看来AMD这次是铁了心,要跟英伟达掰手腕了。
在去年7月11日中午收到那条信息之前,马修·范·安德尔(Matthew Van Andel)的生活一直非常规律且安稳。他就职于一个著名的跨国媒体集团,担任施工经理的工作。
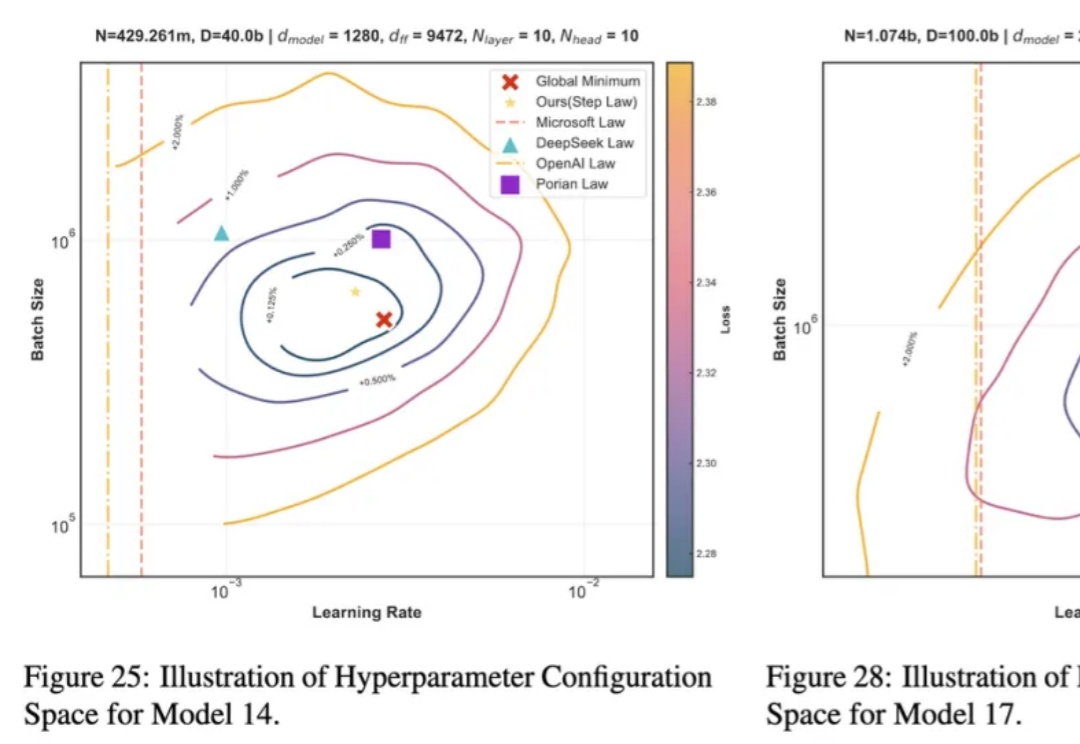
近年来,大语言模型 LLMs 在多种任务上的卓越表现已得到广泛认可。然而,要实现其高效部署,精细的超参数优化至关重要。为了探究最佳超参数的规律,我们开展了大规模的实证研究,通过在不同配置上进行网格搜索,我们揭示了一套通用的最优超参数缩放定律(Optimal Hyperparameter Scaling Law)。
Anthropic 昨晚发布了他们最新的 Claude 3.7 Sonnet 混合推理模型,并在官网同步更新了 Claude 3.7 的系统提示词。
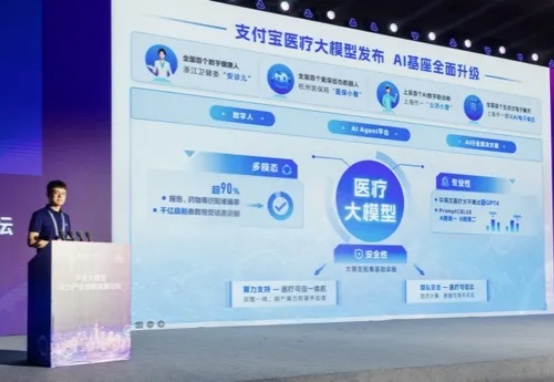
近日,记者发现,国内权威医疗大模型评测平台MedBench在官网更新了榜单。多个医疗AI产品及研究团队入榜,其中蚂蚁AI健康管家团队研发的蚂蚁医疗大模型以评测榜单97.5、自测榜单98.2的高分再度夺得双料冠军。
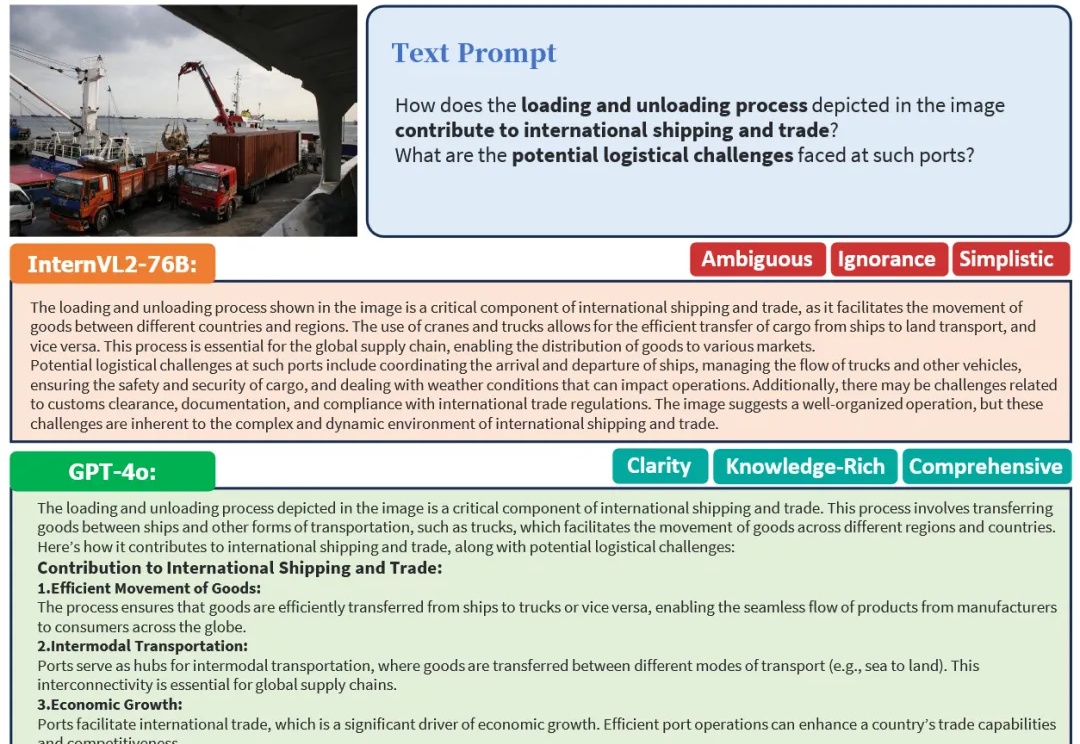
在实际应用过程中,闭源模型(GPT-4o)等在回复的全面性、完备性、美观性等方面展示出了不俗的表现。