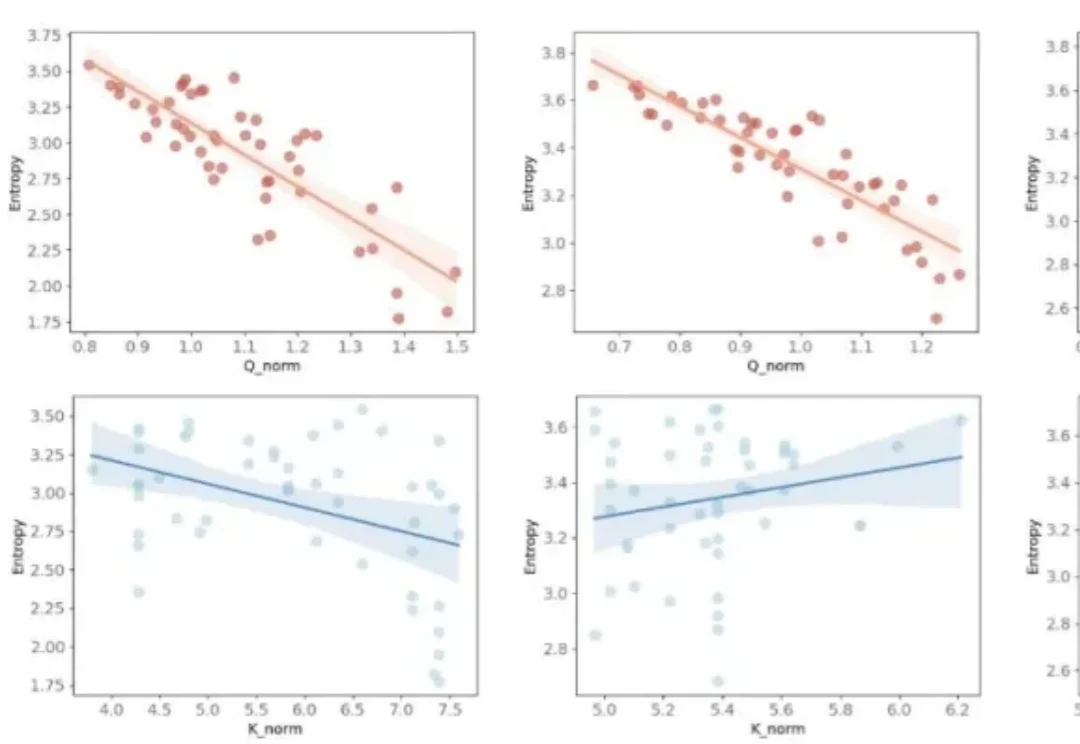
全新线性注意力范式!哈工深张正团队提出模长感知线性注意力!显存直降92.3%!
全新线性注意力范式!哈工深张正团队提出模长感知线性注意力!显存直降92.3%!当 Transformer 席卷计算机视觉领域,高分辨率图像、超长序列任务带来的算力与显存瓶颈愈发凸显:标准 Softmax 注意力的二次复杂度,让 70K+token 的超分辨率任务直接显存爆炸,高分辨率图像分割、检测的推理延迟居高不下。
来自主题: AI技术研报
6633 点击 2026-03-17 08:48

 搜索
当 Transformer 席卷计算机视觉领域,高分辨率图像、超长序列任务带来的算力与显存瓶颈愈发凸显:标准 Softmax 注意力的二次复杂度,让 70K+token 的超分辨率任务直接显存爆炸,高分辨率图像分割、检测的推理延迟居高不下。
3月16日阿里内部围绕“Token”链路,重新梳理整合了业务架构,并成立了新事业群:Alibaba Token Hub(ATH)事业群,阿里巴巴CEO吴泳铭将直接负责这个事业群。这也是自阿里内部电商事业群整合以来,最重要的一次架构调整。
投资界获悉,月之暗面Kimi正以投前估值180亿美元(约合人民币1200亿),进行新一轮10亿美元融资。大约一个月前,Kimi刚刚完成逾7亿美元融资,彼时估值100亿美元;而在去年底一轮5亿美元融资中,其估值还只是43亿美元。
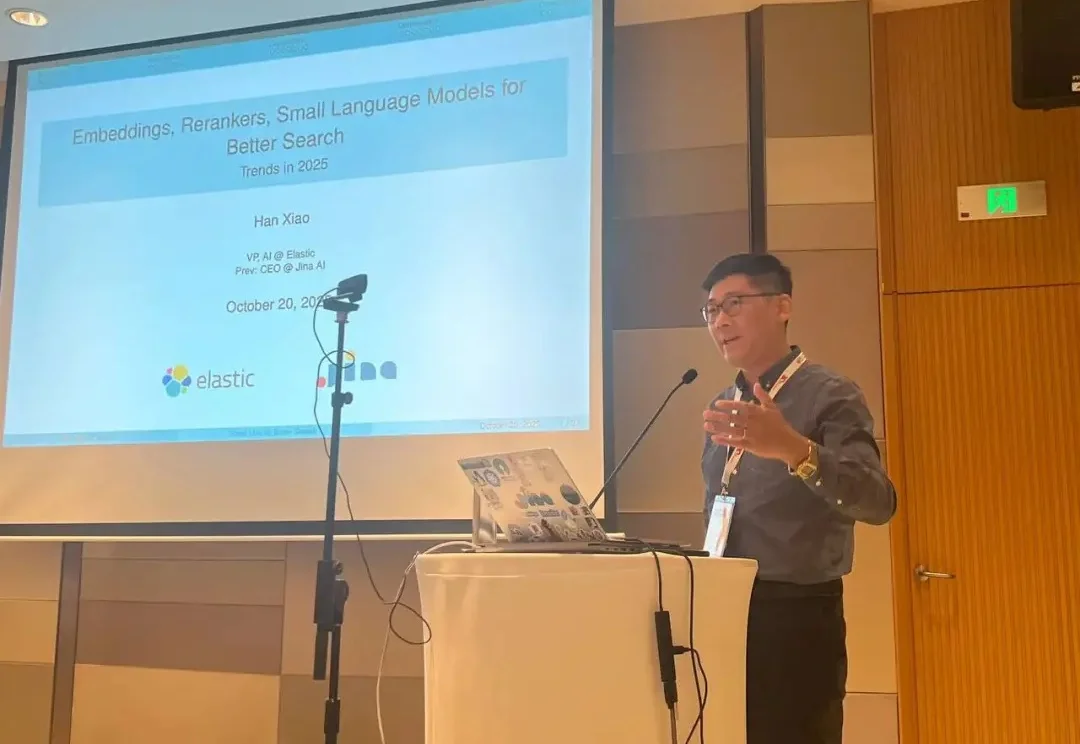
Google 最近发了 Gemini Embedding 2,他们第一个原生多模态向量模型。文本、图像、视频、音频、文档,全部映射到同一个 3072 维向量空间。这是 Omni Embedding(全模态向量模型)的大趋势:一个架构吃下所有模态,从 jina-embeddings-v4 到 Omni-Embed-Nemotron 再到 Omni-5,大家都在往这个方向收敛。
上周带大家 0.83 拿下了 GPT Team,后台好多人问我,这个会员能不能变成 API 来用。答案是可以的,而且玩法比你想的多得多。今天这篇就手把手教你怎么搞定,全程跟着做就行,不需要什么技术基础。
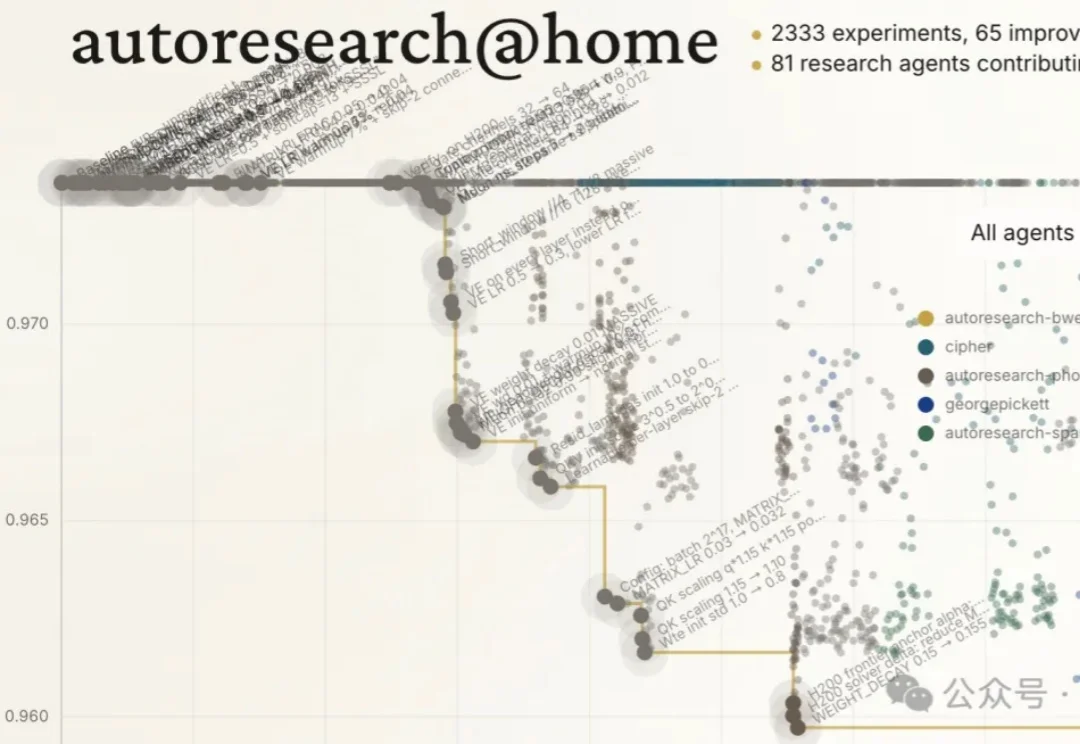
Karpathy让AI通宵干活,自己去蒸桑拿了。
国产大模型集体“中毒”,虚假产品“毒害”消费者。

大家好,我是袋鼠帝。 我最近做了一个挺有意思的实验。
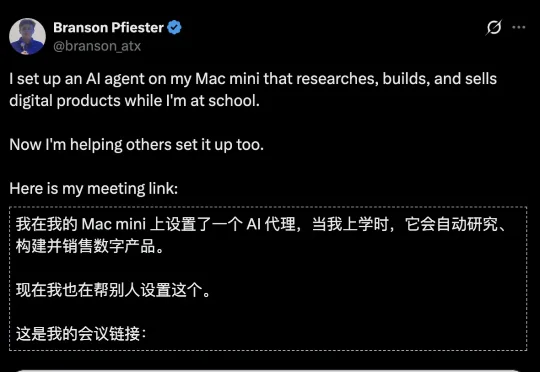
在奥斯汀的龙虾大会,15岁的Branson Pfiester分享了他的养虾经历—— 在过去三周里,他使用Home Club这个平台,创造了超过3万美元的合同收入。他还有一个「知识抓取机器人」。当有新客户时,它会对他们进行全面的研究,帮他弄清楚帮助他们业务的最佳方式等等。
这段时间除了有各种 OpenClaw(龙虾)的倡导事件,业内还有一些警告提醒,截至 2026 年 3 月 14 日,OpenClaw 在国内遭遇密集的安全预警和使用限制。本文梳理了从国家级监管机构、金融行业到高等院校各层级已公开的限制措施。