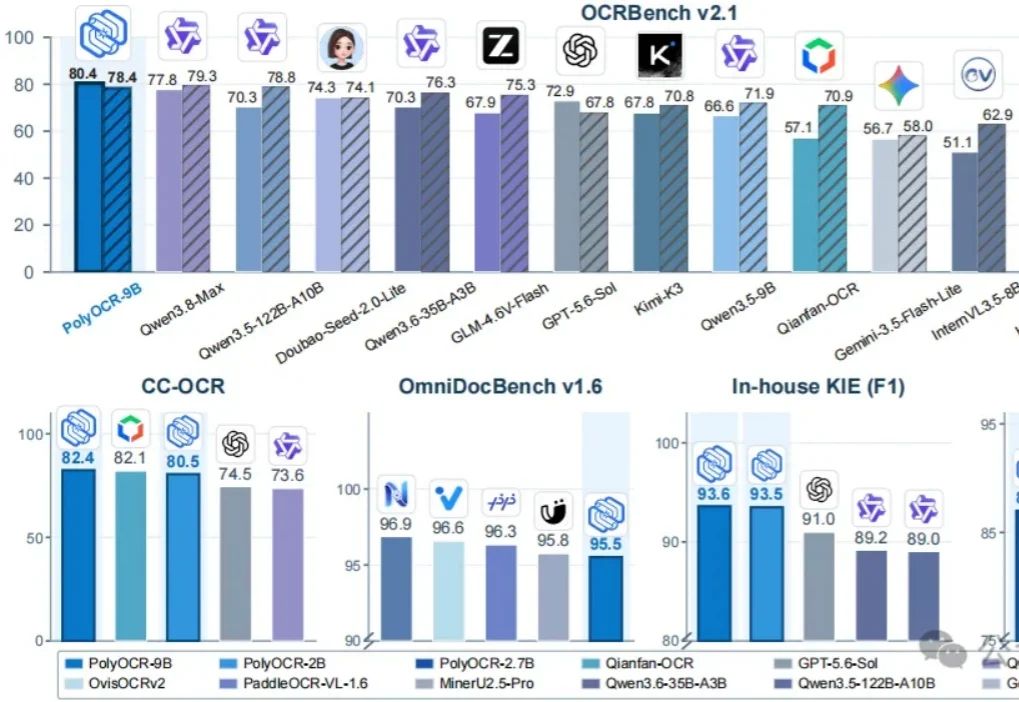
蚂蚁推出OCR大模型:同一架构实现全场景文本智能,2B参数也能打
蚂蚁推出OCR大模型:同一架构实现全场景文本智能,2B参数也能打随着多模态大模型越来越强,OCR的短板反而逐渐明显。
来自主题: AI技术研报
8887 点击 2026-10-29 11:25

 搜索
随着多模态大模型越来越强,OCR的短板反而逐渐明显。
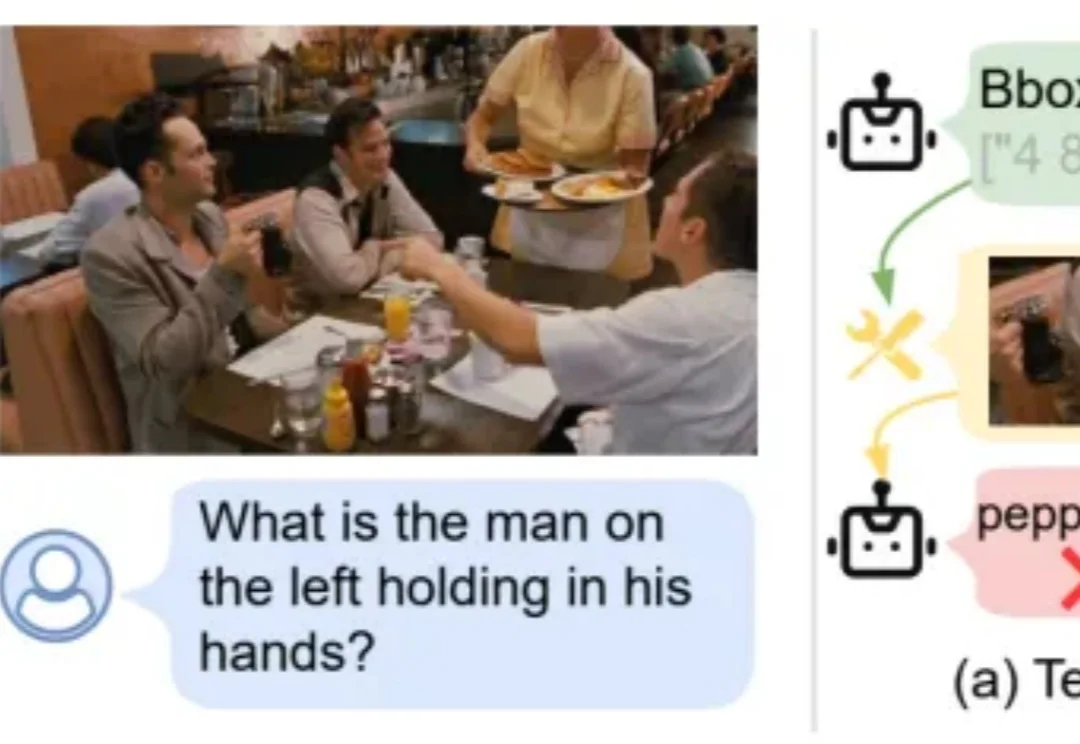
一张高清照片中,远处的手提包是什么颜色?一页票据里,某项费用到底是多少?面对这些问题,多模态大模型常常需要先找到相关区域,再放大查看。但如果第一步就框错了位置,后面的推理也可能跟着出错。视觉思维链让模型能够边看边想、调用工具寻找证据。不过,许多方法仍然像生成句子一样,把边界框坐标逐个写成文本 token。连续的空间位置,为什么要通过离散文字来表达?
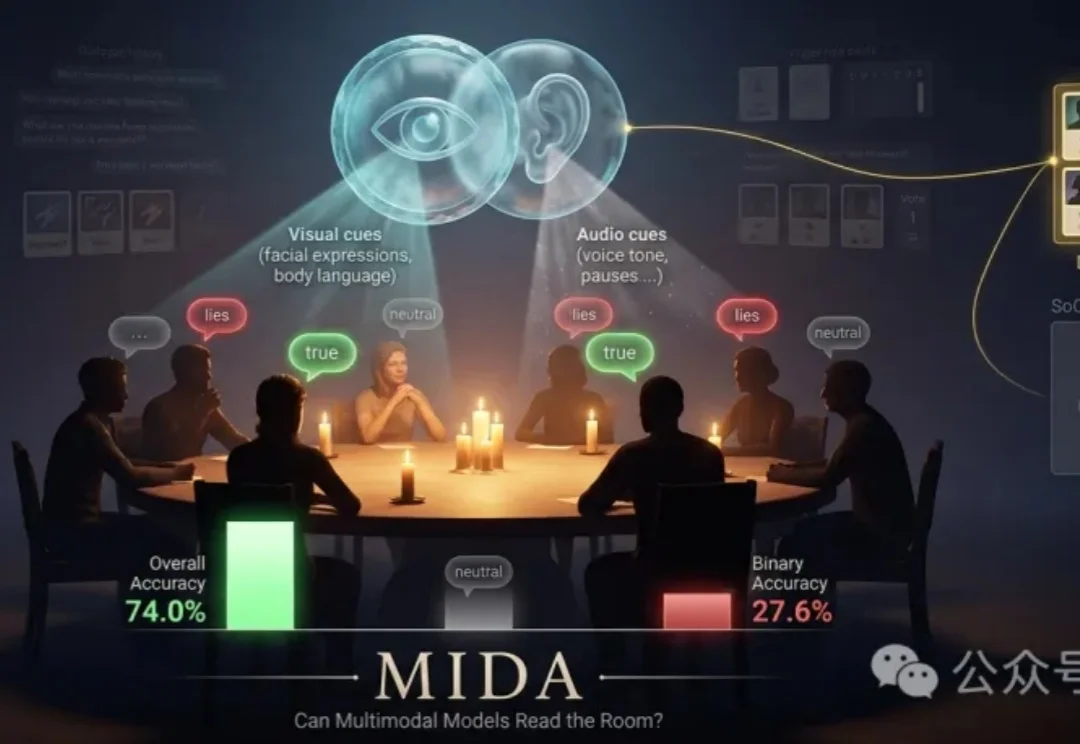
人类说一句「我不是狼」,多模态大模型既能看到表情,也能听见声音。但它真的知道这句话是真是假吗?
10月21日,柏林GTC大会,黄仁勋又把AI的未来讲出了新高度。
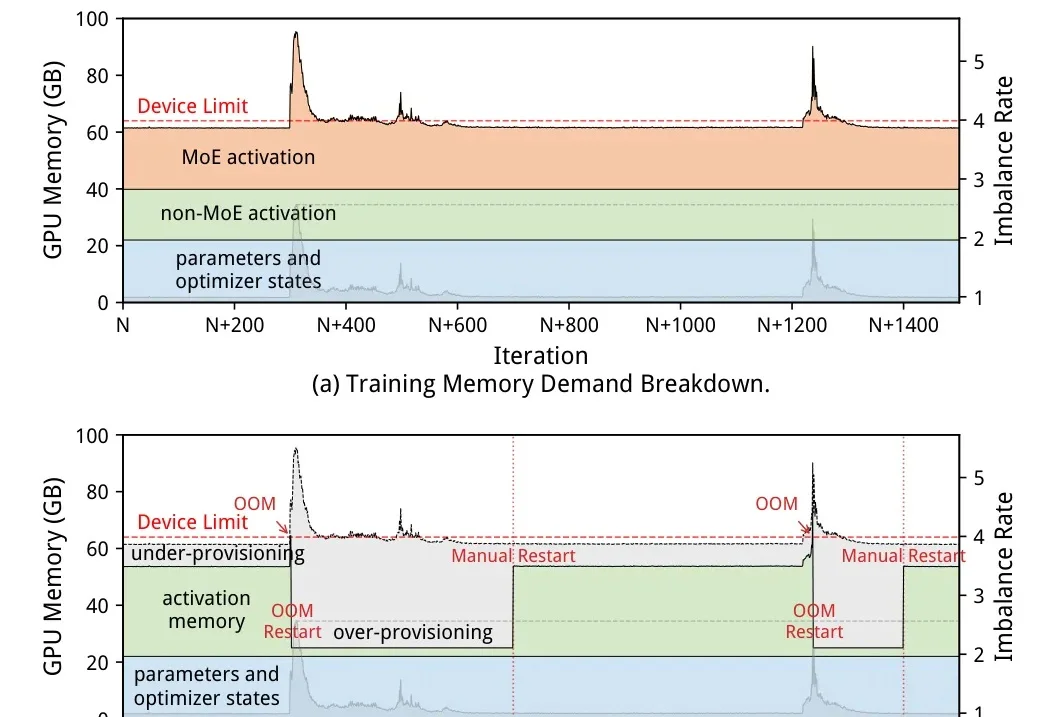
大模型训练已经跑到万卡集群规模,显存始终是那道隐形的门槛。
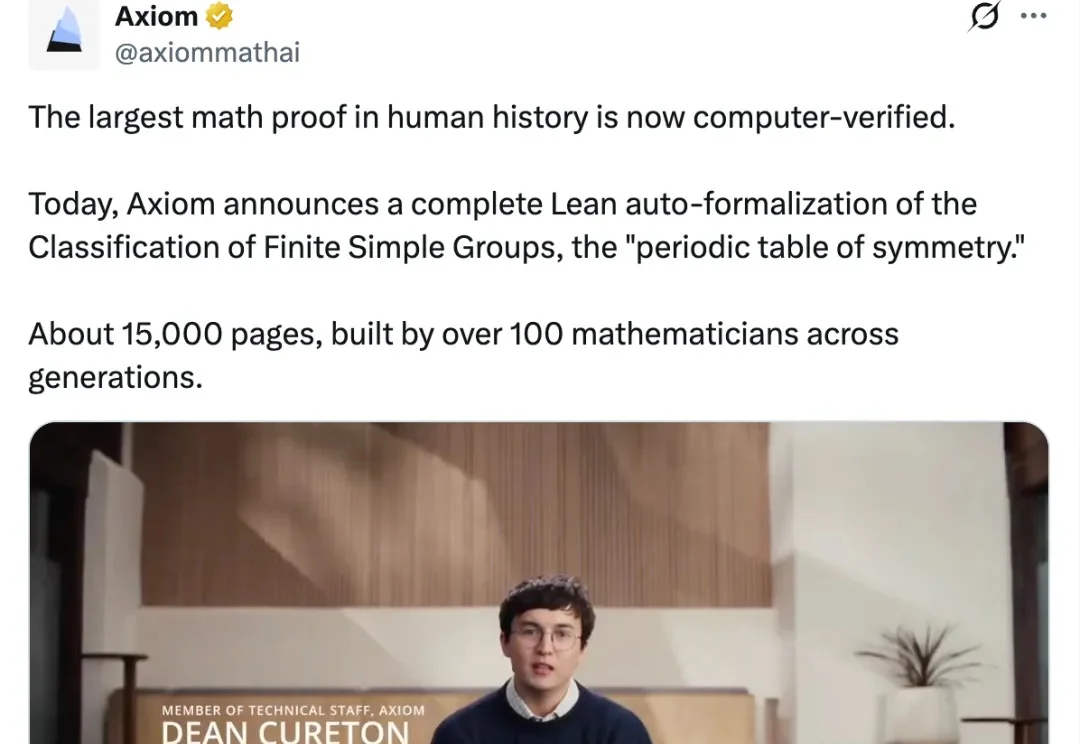
100 多位顶尖数学家,耗费数十年,写下 1.5 万页证明。
天道好轮回!
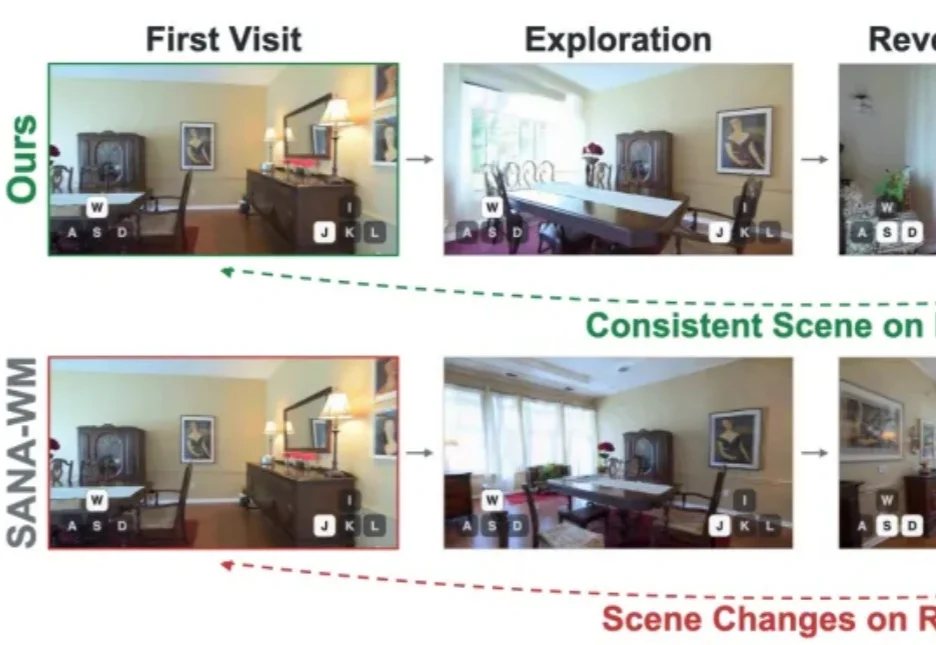
近两年,视频世界模型(video world model)成为生成式 AI 最受关注的方向之一。只需给定一张参考图和一段场景描述,模型就能根据用户输入的相机位姿或控制指令,逐帧生成出一个可以自由漫游的虚拟世界。
英伟达宣布向Meta投资30亿美元,并扩大Muse个人智能体及Muse系列模型合作,Meta同时计划募资950亿美元,以支撑AI基础设施和资本开支。
K2 Lab(攀峰智能)做到了很多 AI 应用想做但没做到的商业模式:不按 Token 收费,按结果收费。