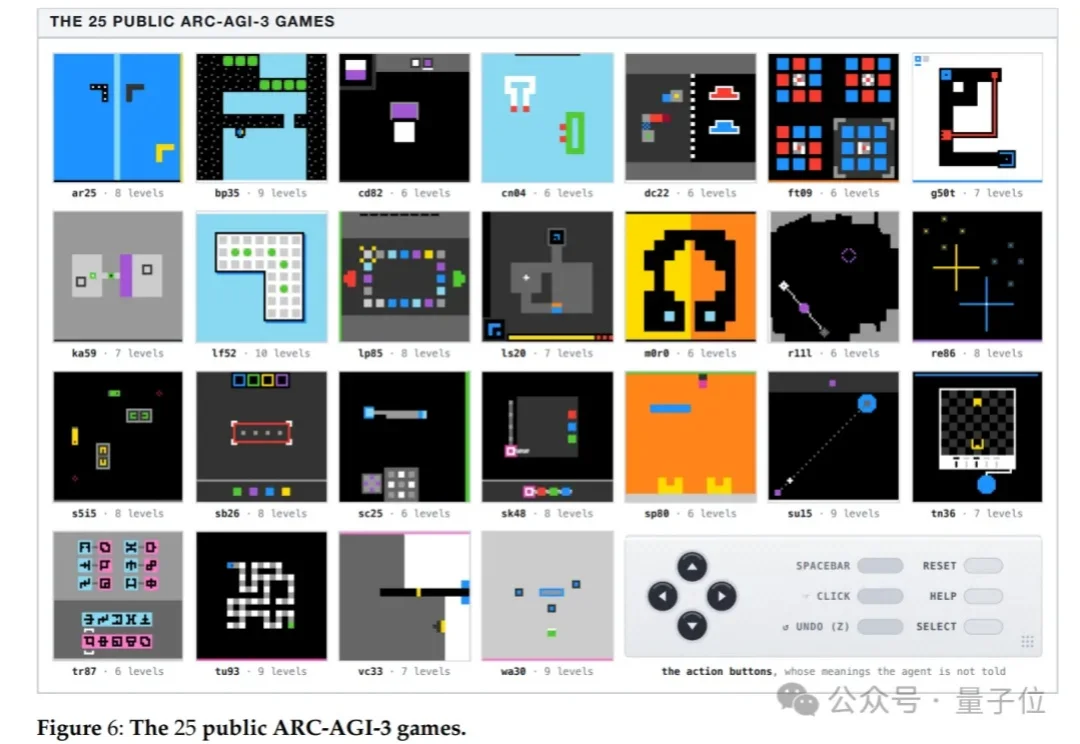
华为AI靠RSI通关25款游戏!操作次数比人类少56%
华为AI靠RSI通关25款游戏!操作次数比人类少56%一边打游戏,一边给自己升级?
来自主题: AI技术研报
8074 点击 2026-10-13 14:25

 搜索
一边打游戏,一边给自己升级?
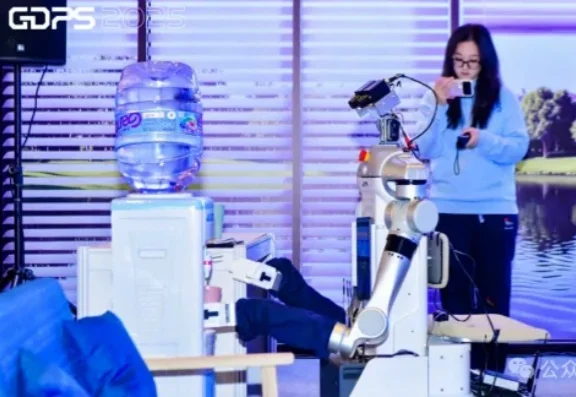
机器人界的“劳模”评选,这就安排上了!
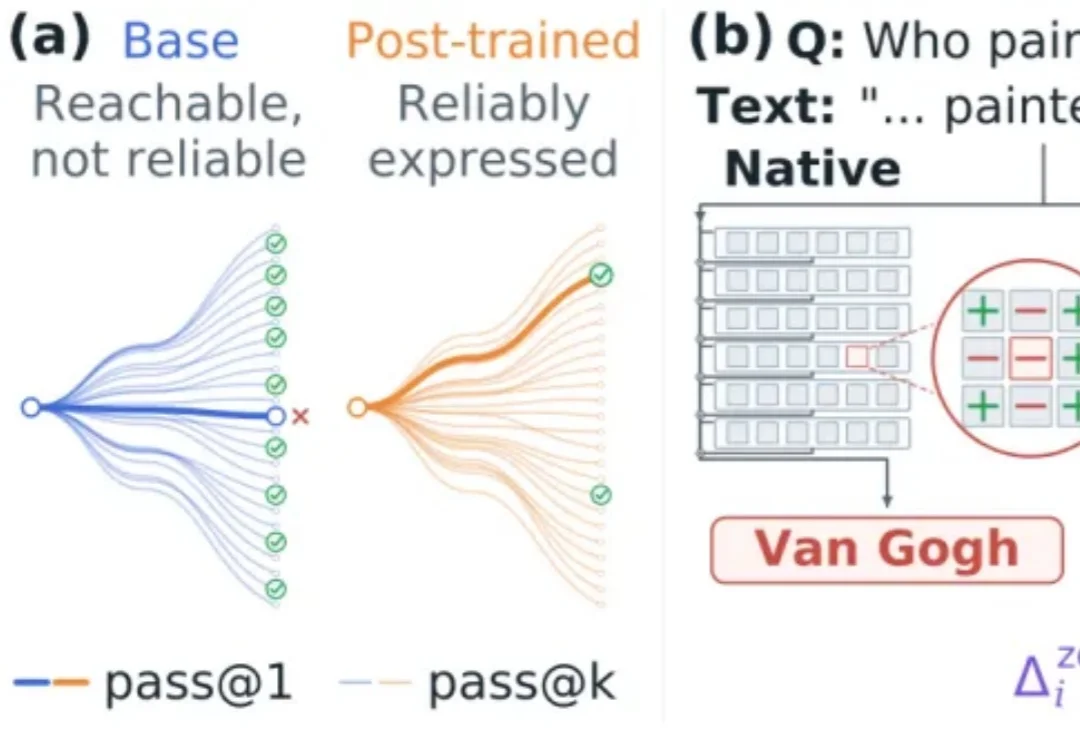
让大模型稳定地按人们的期望行动,是偏好对齐的核心目标。
国庆前,海外各家大厂的Personal Agent产品下饺子一样出现。
A2A 商业马拉松,刚开跑。
大厂林立,独立AI Infra厂商凭何能冲出重围?
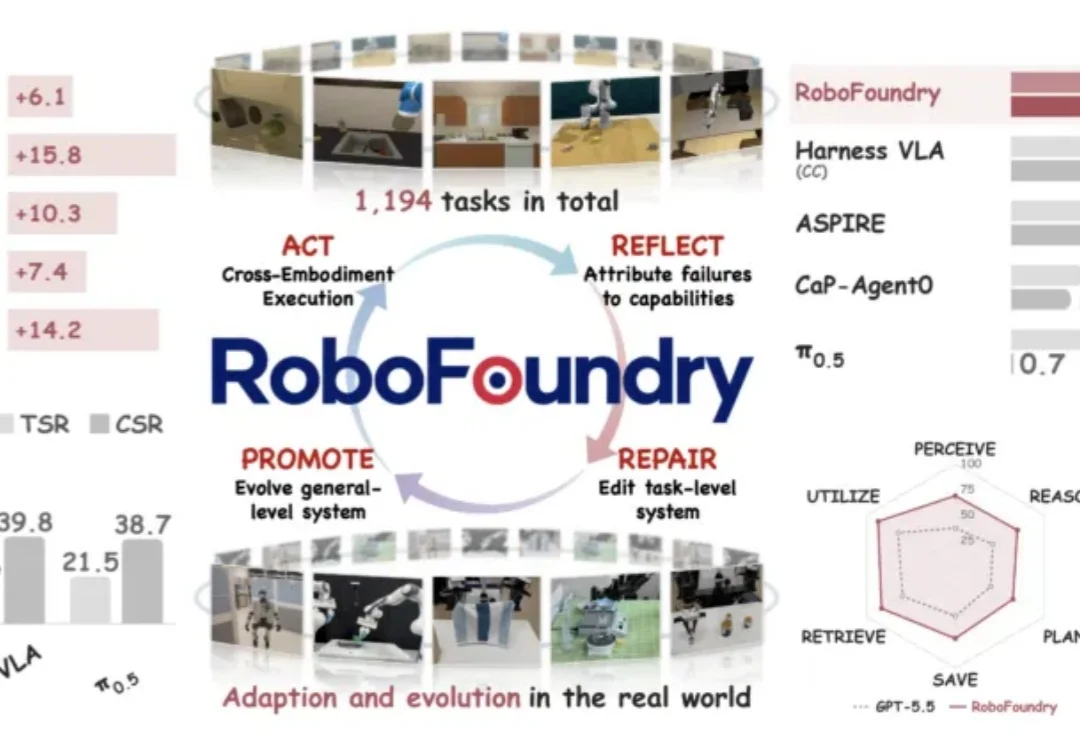
同一个 GPT-5.5,放进不同的系统里,做具身任务的表现可以相差悬殊。在 EmbodiedBench 上,直接使用 GPT-5.5 的平均成功率是 56.9%;模型参数一个不改,只让它周围的系统持续进化,这个数字变成了 72.7%。
vLLM Semantic Router推出并开源Decision 3.0系列多模态决策模型,覆盖0.6B至27B六款模型,其中d3在Jev Decision Index 0.3.1文本榜和视觉榜均排名第一。
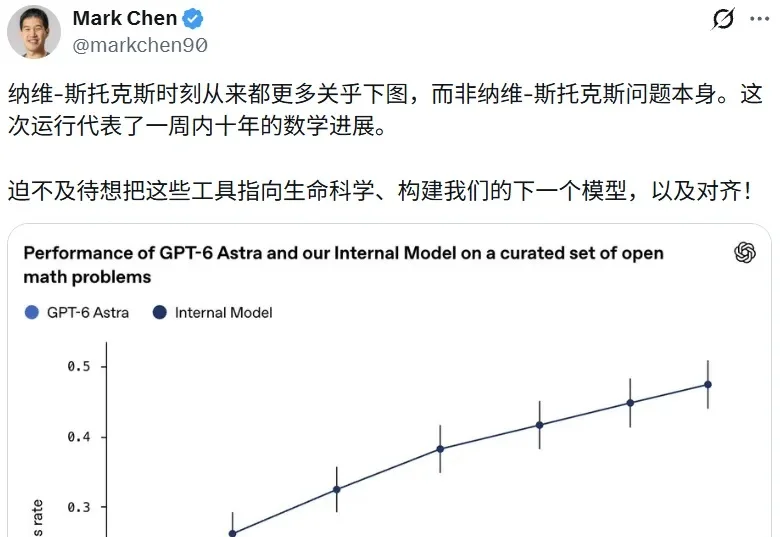
前些时日,OpenAI 在 GitHub 上一口气放出了 722 篇数学论文手稿。这些手稿被归为 372 个结果「家族」,横跨 17 个数学领域,全部出自一个尚未发布、也没有公开名字的内部模型——其性能远胜 GPT-6 Astra。
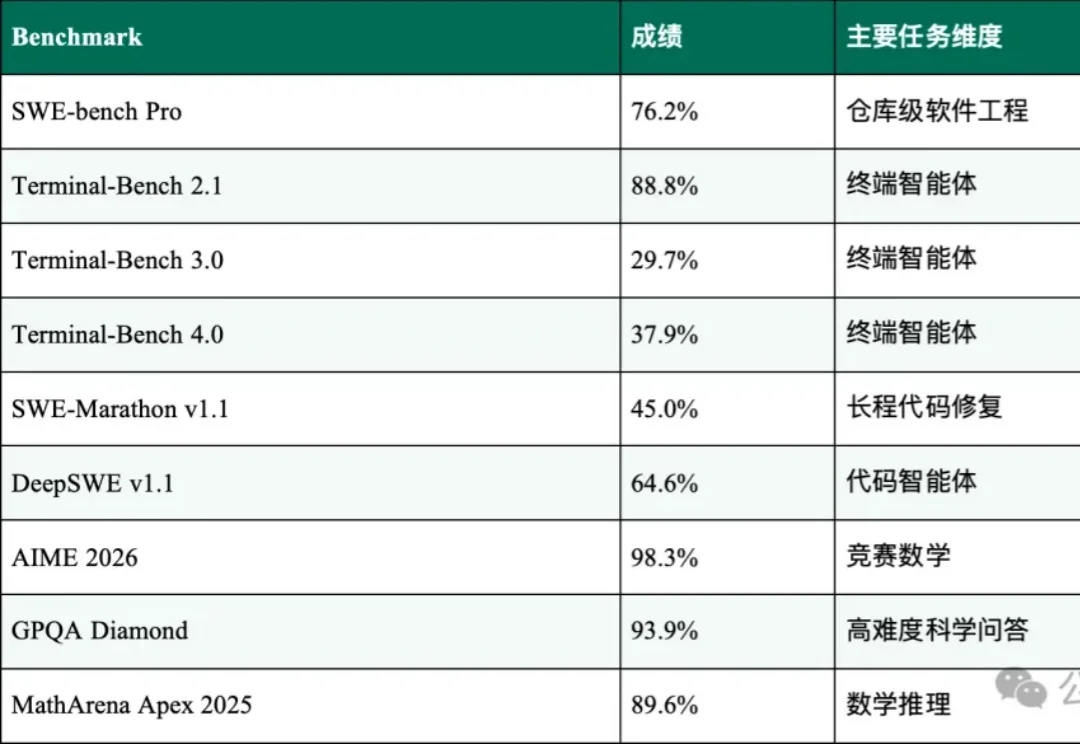
随着前沿模型进入长链推理、工具调用、代码修复与科研任务,一个关键缺口随之显现:模型不断生成和修改候选,但“新状态是否真的更可靠”不能只由模型自己判断。