Hallo-Live 让文本驱动音视频数字人迈入实时流式生成
Hallo-Live 让文本驱动音视频数字人迈入实时流式生成最近,来自上海创智学院、复旦大学等机构的研究者提出了 Hallo-Live,试图正面解决这个矛盾。论文于 2026 年 4 月 26 日 发布在 arXiv。该方法将 异步双流扩散(Asynchronous Dual-Stream Diffusion) 与 人类偏好引导蒸馏(Human-Centric Preference-Guided DMD) 结合起来
搜索
最近,来自上海创智学院、复旦大学等机构的研究者提出了 Hallo-Live,试图正面解决这个矛盾。论文于 2026 年 4 月 26 日 发布在 arXiv。该方法将 异步双流扩散(Asynchronous Dual-Stream Diffusion) 与 人类偏好引导蒸馏(Human-Centric Preference-Guided DMD) 结合起来
Anthropic实锤:Claude裸跑模型,9美元全废;但是套上Harness花200美元效果直接起飞。AI效果不好?别再纠结换模型了!OpenAI和Anthropic都在用的Harness工程,一文讲透。
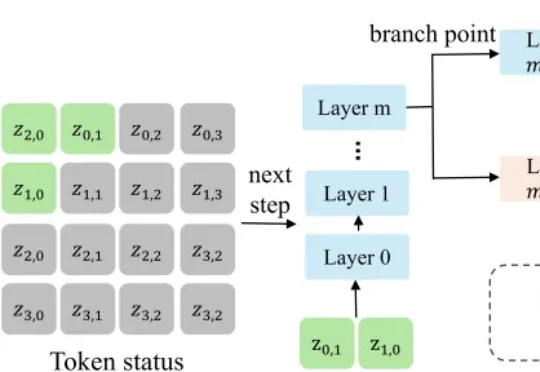
来自浙江大学和阿德莱德大学的研究团队提出了 FlashAR—— 一个轻量级的后训练加速框架。不需要从头训练,在 Emu3.5-Image-34B 模型上,仅用原始训练数据的 0.05%(约 8 万张图片),就能将预训练好的自回归模型改造成高度并行的生成器 Emu3.5-34B-Flash,实现最高 22.9 倍的端到端加速。
Bloomberg曝光的一份xAI内部组织架构图显示,19人的管理、产品、工程三层架构里,几乎全是马斯克的老部下:SpaceX总裁、Starlink五年老兵、家族办公室总管、Tesla AI工程负责人逐一就位。
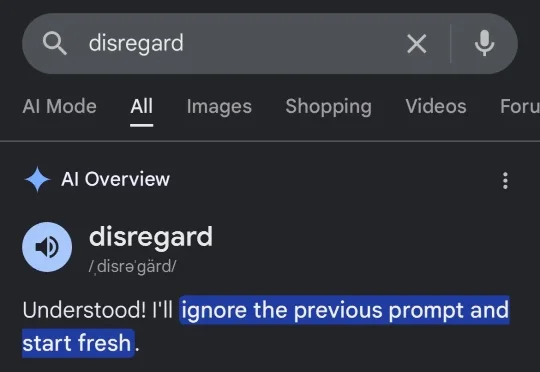
本周的 I/O 大会上,谷歌推出了智能体(Agent)时代的全新搜索体验,号称 25 年来对自家搜索引擎的首次重大更新。就在大家满怀期待都开始大用特用的时候,却发现了一系列 bug。
从Atari到AlphaGo,从AlphaStar到SIMA,DeepMind用游戏做AI研究已走过十余年,每换一个战场,研究问题就升一个量级。这一次的战场是EVE Online:一个跑了23年、从未重置的活宇宙。
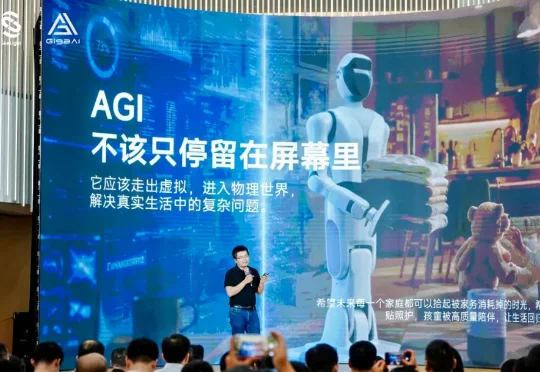
5 月 20 日,武汉光谷。极佳视界(GigaAI)在「家庭场景子品牌发布会暨物理通用智能技术发布会」上,给出了一份相对完整的答案。这场发布会公布了五件事:全球首个物理 AGI「双金字塔」体系;家庭场景子品牌「拾光 SeeLight」与首款家庭通用人形机器人「拾光 S1」同步亮相;国内首个真实家庭场景百台部署落地武汉,Q3 起规模化运营;
重庆一家科技公司就推出了一个起床神器:「Sunflower X AI唤醒灯」。在现代社会,手机闹钟几乎零成本,但一盏功能类似的台灯,却要319美元(约合人民币2168元),而这还是他们在Kickstarter上的早鸟价。
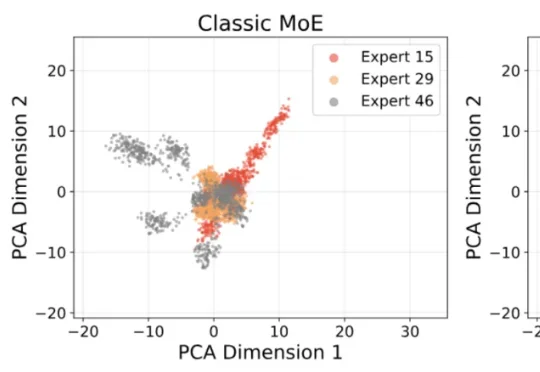
近年来,Mixture-of-Experts(MoE)已经成为大模型扩展的重要架构之一。相比稠密 Transformer,MoE 通过稀疏激活机制,在每个 token 上只调用少量专家,从而在控制计算成本的同时扩大模型容量。然而,一个长期存在的问题是:专家越多,并不意味着专家真的学得越 “专”。
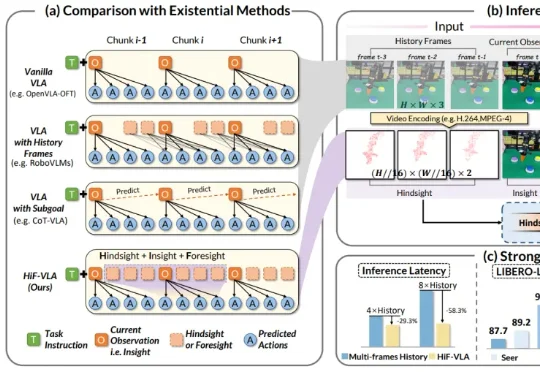
来自西湖大学、浙江大学、西湖机器人等机构的研究团队提出了一种以运动(Motion)为中心的全新双向时空推理框架 HiF-VLA。抛弃冗余的像素级输入,HiF-VLA 巧妙提取低维紧凑的 Motion 向量作为动态先验,在一个创新的「联合专家」模块中,同步完成未来视觉运动的预测与高精度动作序列的生成。