
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
北航、南方科技大学、复旦大学、北京理工大学、爱丁堡大学等 8 家机构的 19 位研究者联合完成 Theory of Agent 综述,讨论模型内部与外部 harness 应如何分配能力,并据此梳理 LLM Agent 的学习、对齐、演化与评测。
一个本可直接推理的问题,Agent 却连续搜索网页、调用多个工具。任务虽然完成了,时间和费用也多花了不少。另一种情况是,问题需要实时信息,Agent 却一直在模型内部推理,最后给出流畅但没有依据的答案。
前一种情况属于过度行动(overacting);后一种往往同时涉及过度思考(overthinking)和行动不足(underacting)。要避免这类决策失误,Agent 需要判断哪些问题可以自行解决,哪些必须向外部世界寻求信息或执行能力。
这篇综述梳理了约 600 项近期研究,用内化(internalization)与外化(externalization)这一统一视角,分析 Agent 从设计到学习、对齐、演化和评测的全过程。
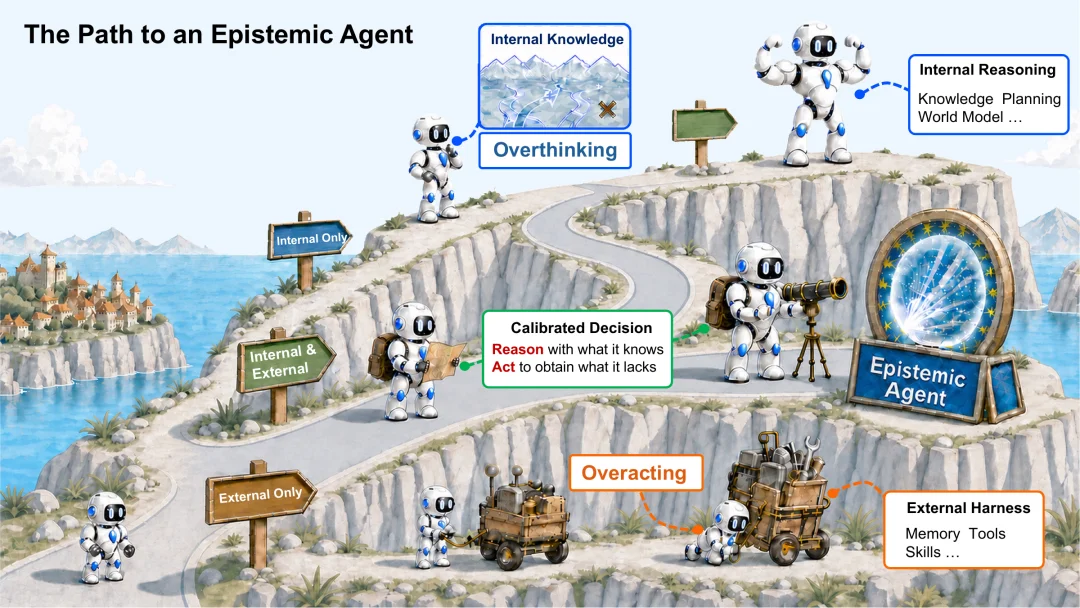
通往认知型智能体(Epistemic Agent)的路径。Agent 根据模型内部知识与外部 harness 的能力,校准思考和工具调用的决策。
LLM Agent 通常由模型和外部 Harness 两个紧密耦合的部分组成:
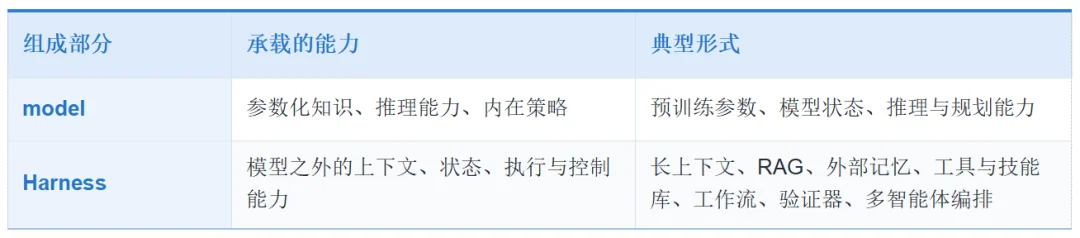
过去数年的 Agent 进展,大体围绕这两个部分展开:基础模型与推理模型的能力在增强,外部 harness 也在持续扩展。
设计这样的系统时,需要同时考虑两个问题:知识、技能和控制分别放在模型参数还是外部系统;在具体步骤上,内部推理与外部行动各投入多少。
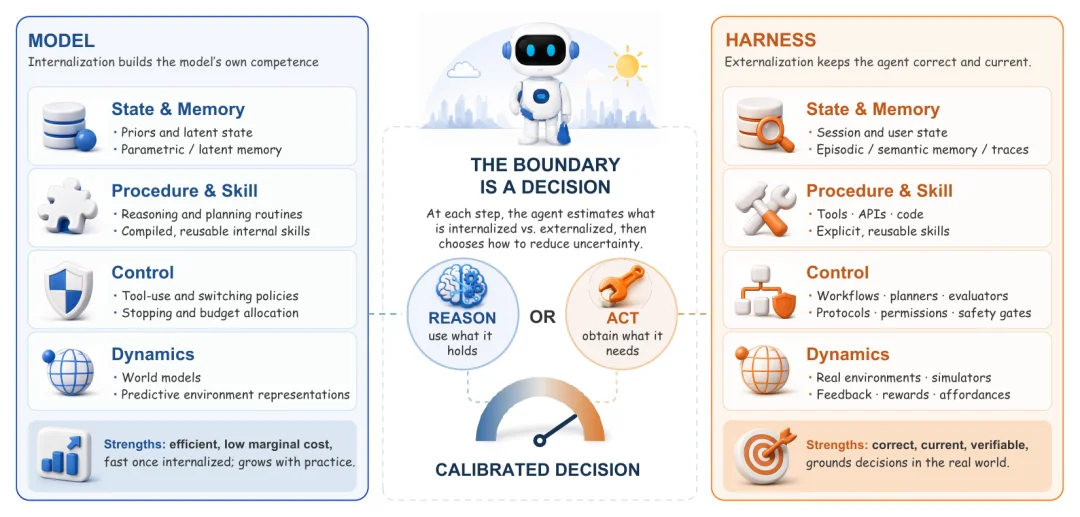
图 1:模型与 Harness 之间的能力配置。模型侧适合承载稳定、高复用、可摊销的能力;Harness 侧适合承载实时、可编辑、可验证、需要治理的能力。两者之间的边界决定 Agent 应继续推理还是采取外部行动。
这些配置问题也出现在几组常见的技术选择中:
论文围绕内化与外化的边界,依次讨论学习、对齐、演化与评测:
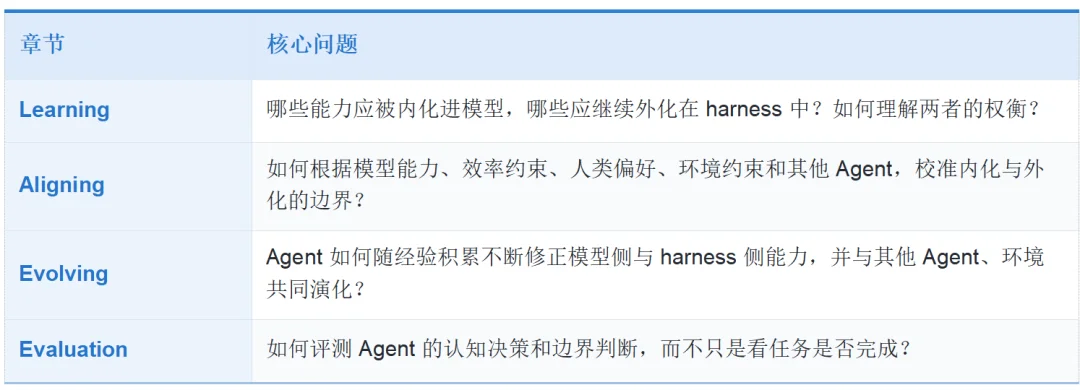
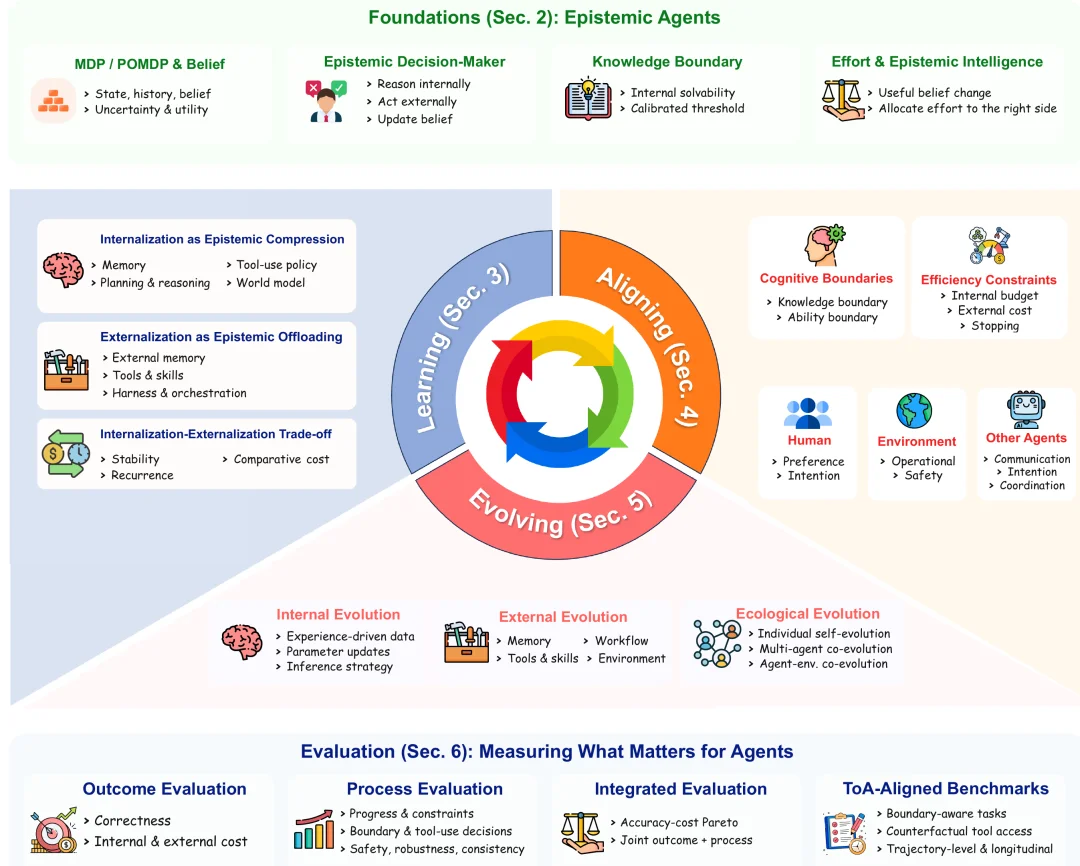
图 2:论文整体结构。Foundations 给出统一概念与形式化基础,随后依次讨论 Learning、Aligning、Evolving 和 Evaluation,最后讨论开放问题。
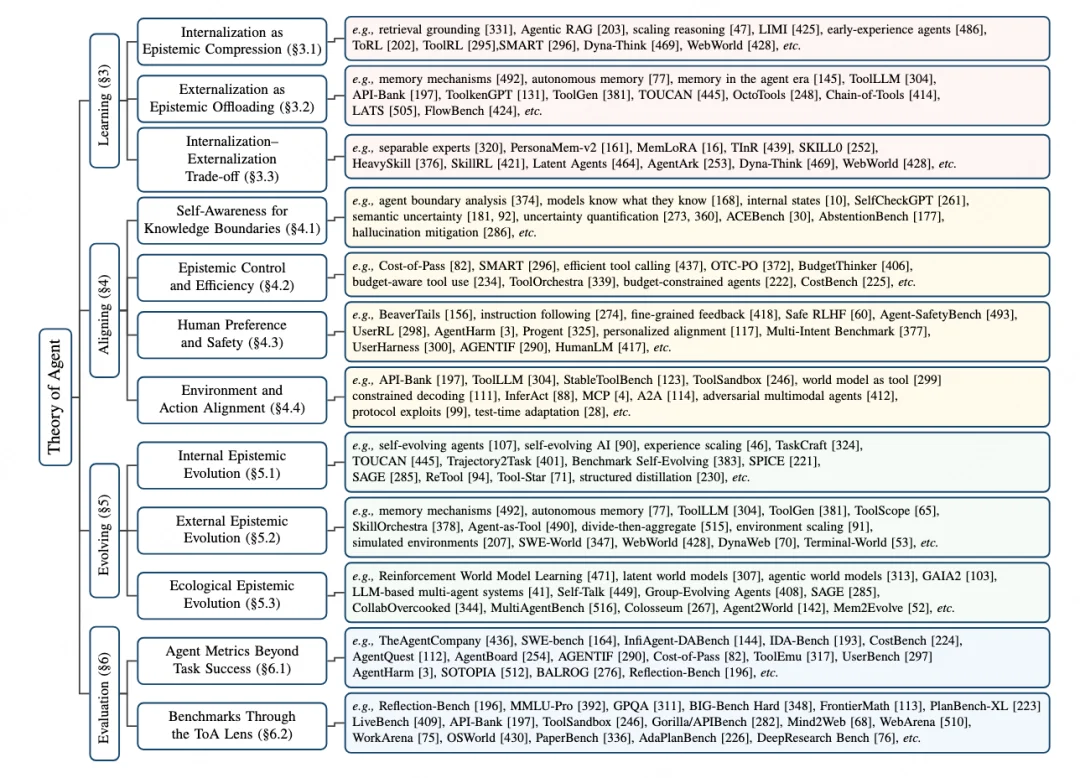
图 3:AI Agent 研究分类。相关工作按 Learning、Aligning、Evolving 与 Evaluation 四个研究问题组织,并映射到内化与外化的边界。
传统视角通常把 Agent 描述为从状态或交互历史映射到动作的策略,重点考察任务是否完成。
这篇综述关注决策过程:Agent 在每个时刻都持有关于任务答案、下一步动作或环境状态的某种信念,并据此判断:
1. 当前信念是否已经足以作出决策;
2. 如果仍有不确定性,应该通过内部推理继续处理,还是通过外部行动获取新信息;
3. 这一步带来的信息增益,是否值得其成本与风险。
论文将 Agent 的动作空间分为两类:
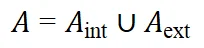
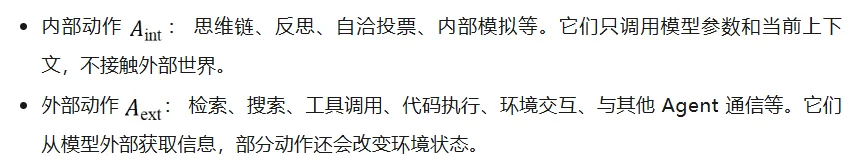
推理与行动都属于减少不确定性的 “知识操作”。内部推理利用模型参数和当前上下文,外部行动则从外部世界获取信息。
知识边界会随模型、任务和环境变化
论文定义了两个任务集合:
两者之间的分界就是 Agent 的知识边界(knowledge boundary)。不同模型的边界不同;同一模型的边界也会随任务、上下文、工具可用性、信息时效性和训练进程变化。
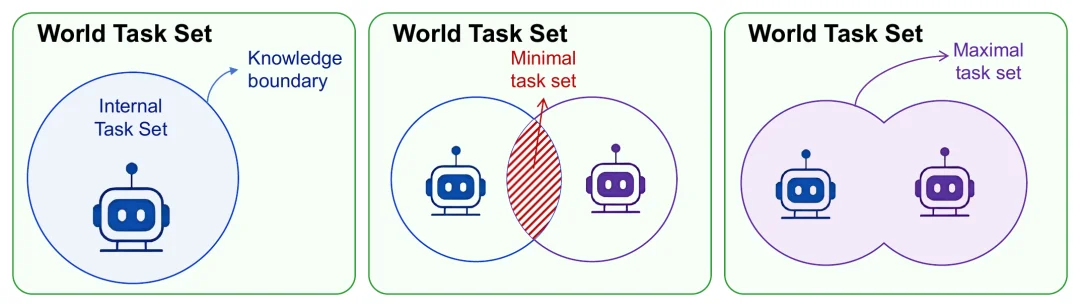
图 4:不同模型或 Agent 拥有不同的内部任务集。能力增强会扩大内部可解区域;多个 Agent 的能力也可能互补,形成更大的联合任务集。
工具的可用性与必要性需要分开判断。任务位于内部任务集时,调用工具可能有帮助,但并非必需;当任务超出内部能力时,外部行动才具有认知必要性。
四种常见失误,如何对应边界误判?
论文从边界估计和行为表现两个维度解释常见失败:Agent 可能高估或低估自身能力,相应的失误则出现在推理侧或行动侧。
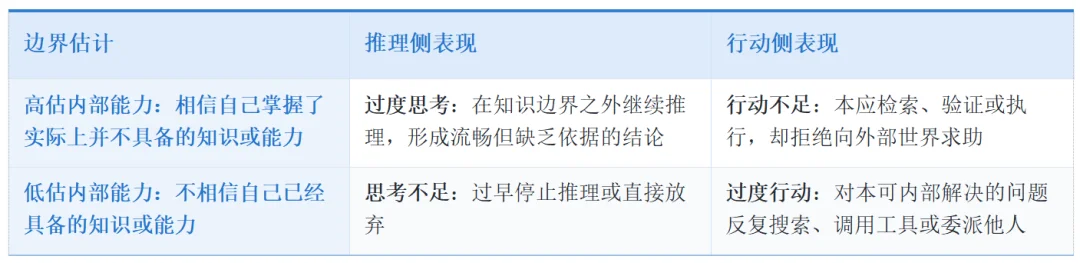
工具调用次数和推理长度都不能单独用来判断决策好坏。Agent 需要根据自身能力、任务要求和外部成本,找到合适的 operating point。
认知努力:推理与行动各投入多少?
论文将任务中的认知努力分解为:
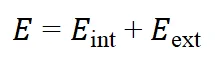

切换策略会改变任务信息负担的承担方式,却不会让它消失。更强的模型可以在内部处理更多工作,较弱的模型可能更依赖外部 harness。两者都需要合理分配内部推理与外部行动,避免无效投入。
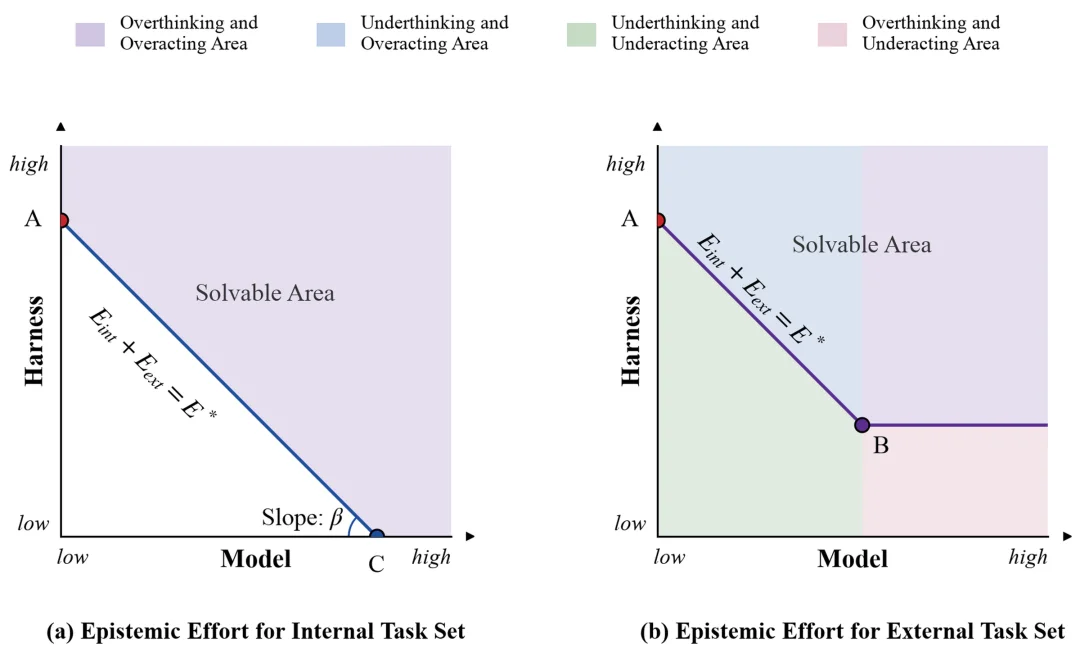
图 5:内部任务与外部任务对应不同的理想努力分配点。过度思考、思考不足、过度行动和行动不足,都是偏离理想点的边界失准。
论文用认知智能比率(epistemic intelligence ratio)衡量单位努力带来的有效信息增益:
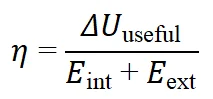

论文将 η 作为认知智能的可观测指标,但它无法完整定义认知智能。Agent 还需要识别自身边界,合理分配内外部努力,在两侧都无法解决问题时合理拒绝,并通过学习扩大内部能力边界。
在这一框架中,学习要决定哪些能力通过训练进入模型,哪些继续由外部系统提供。
对应的两条路线是内化与外化:
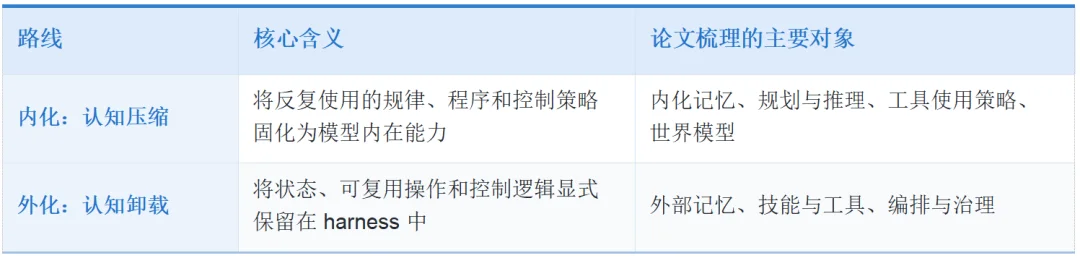
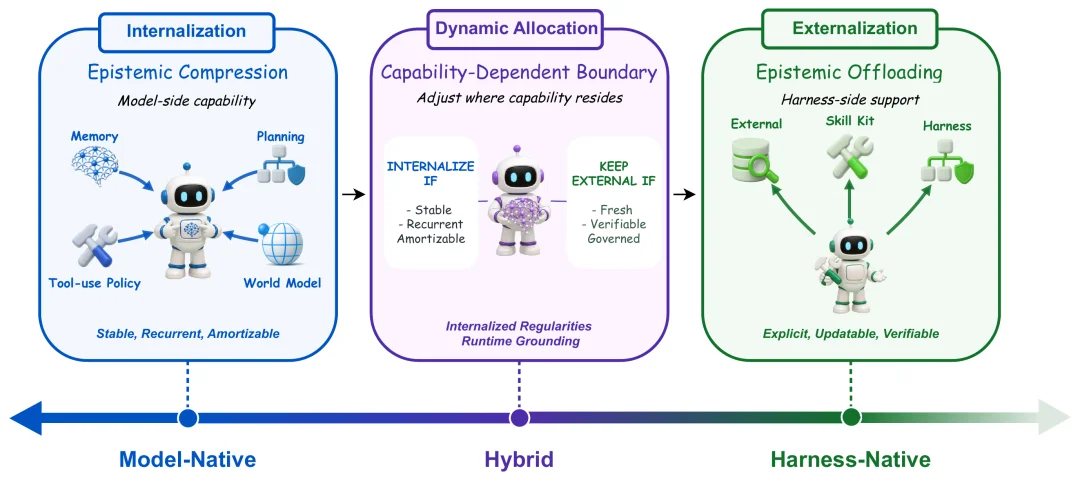
图 6:从 model-native 到 harness-native 的能力配置连续谱。动态配置层依据当前能力边界,决定哪些能力进入模型,哪些留在外部系统。
内化:将反复使用的过程转为模型能力
论文从四个方面梳理内化研究:
1. 内化记忆通过保存和学习历史信息,影响模型后续行为。稳定的用户规律、反复出现的任务模式和高频经验,可以逐步进入模型状态、适配器或参数。
2. 内化规划与推理,把任务分解、搜索、反思和验证等临时生成的过程,转化为较稳定的程序性能力。
3. 内化工具使用策略,既学习工具调用格式,也学习何时调用、选择哪个工具、如何构造参数,以及如何根据返回结果继续决策。
4. 内化世界模型,通过学习环境动力学和动作后果,在执行前进行内部模拟,减少昂贵或不可逆的试错。
外化:让能力保持显式、可编辑、可验证
外部支持包括记忆、技能和编排三类:
1. 外部记忆保存不断变化的状态、交互历史和证据,并通过写入、检索、合并、遗忘等操作管理信息生命周期。
2. 外部技能将程序性知识封装为可检查、可复用、可组合的操作单元,避免每次从头生成流程。
3. 外部编排把控制流、权限、验证、回滚、Agent 协作和工具协议放在 harness 中,使执行过程可观察、可恢复、可治理。
什么时候应该内化,什么时候应该外化?
选择内化或外化时,论文建议考虑以下维度:
长期稳定、经常复现且有摊销价值的规律,适合内化;实时变化、高风险或需要审计的证据与操作,适合保留在外部。许多实际系统最终会采用混合配置:模型内化通用策略,harness 提供实时证据、执行接口和安全边界。
传统 LLM 对齐主要关注输出是否符合人类偏好。Agent 进入真实环境后,还需要决定是否检索、调用工具、执行动作、与其他 Agent 协作,以及何时停止。对齐因此也要覆盖这些决策。
论文将这些决策纳入统一规则,并依据五类约束进行校准:
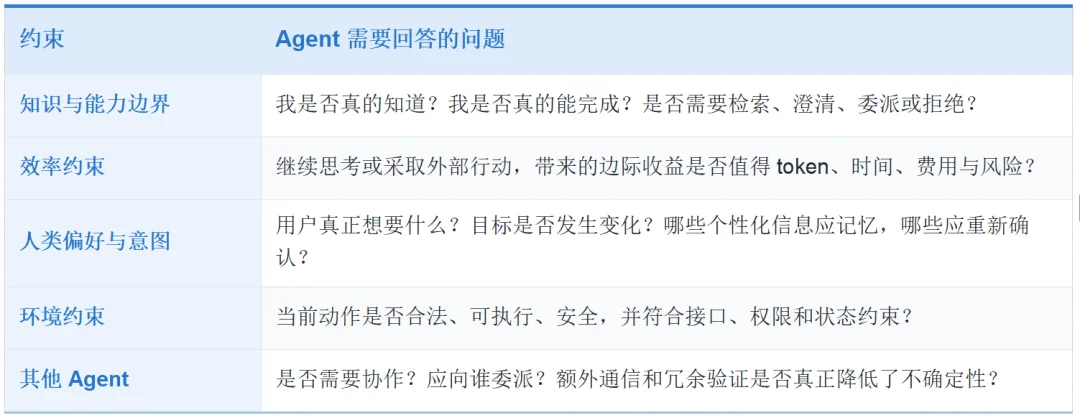
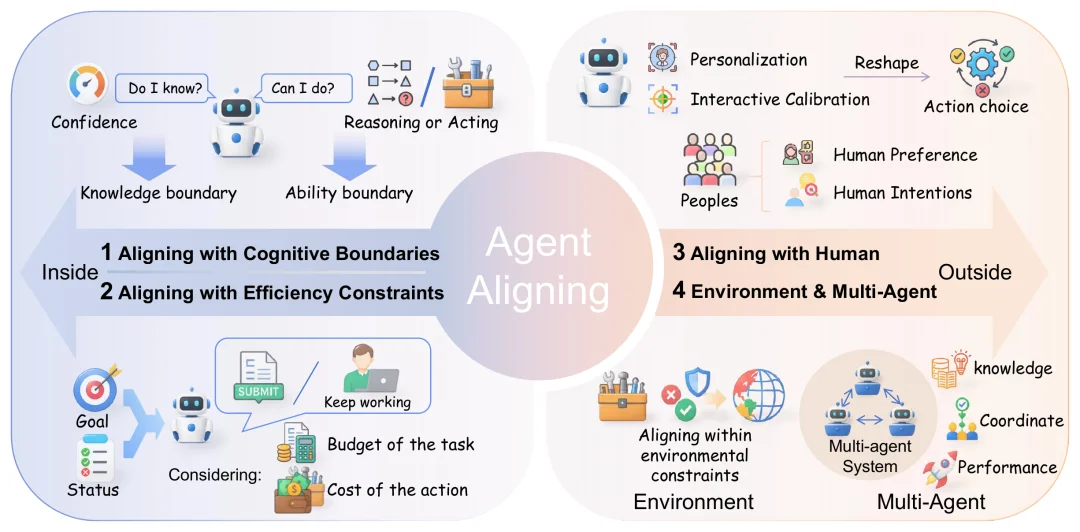
图 7:Agent 对齐的内外两个方向。内部包括认知边界与效率约束,外部包括人类、环境和多智能体系统。
沿着这五类约束,论文讨论了几项具体要求:
不确定性估计需要落实到行为选择。只有当分数能够指导 Agent 回答、检索、澄清、验证或拒绝时,它才体现了自我认知。
工具路由要区分可用性与必要性,并随模型能力、任务和当前状态动态调整。
个性化需要区分信息类型:稳定、低风险的偏好可以压缩或内化;敏感、可撤销或会发生漂移的信息,更适合保留在可审计的外部记忆中。
在工具和 API 环境中,多步执行、权限调用和环境反馈都可能带来风险。安全检查需要覆盖整条轨迹,单看最终回答无法判断过程是否安全。
多智能体协作也要核算成本。新增 Agent、角色或通信边带来的边际信息价值,应高于相应的协作成本。
Agent 发布后仍会持续接触任务、用户、工具和环境。在这个过程中,它可能发现能力缺口,积累经验,更新记忆或生成技能,并与其他 Agent 和环境共同变化。
这些变化对应三个层次的演化:
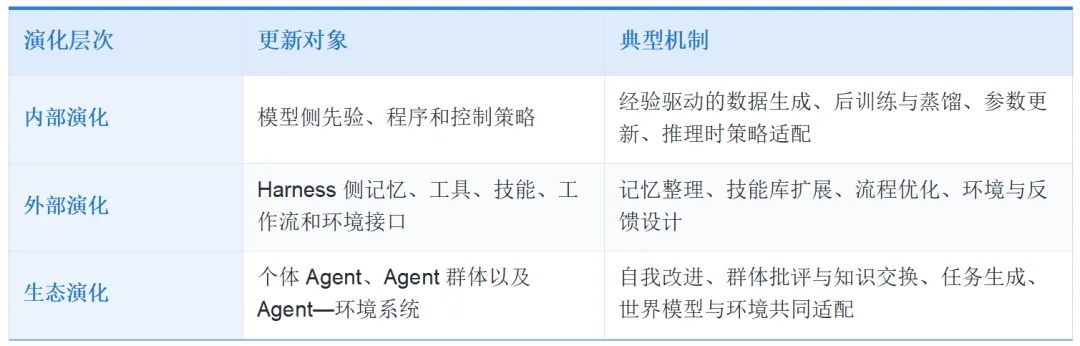
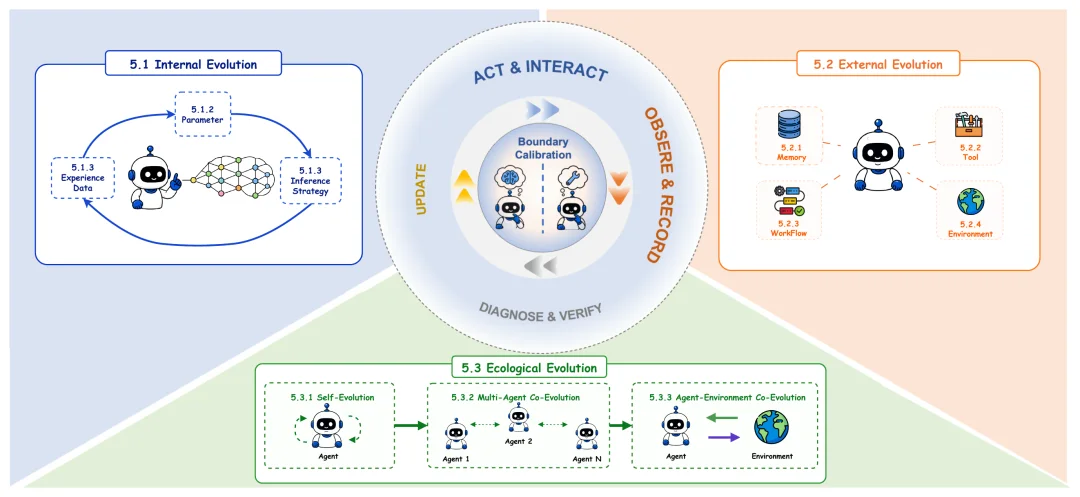
图 8:认知演化的三层反馈回路。内部演化将经验转化为可复用的模型能力,以摊销后续决策成本;外部演化改进 harness;生态演化把群体与环境反馈用于下一轮适配。
衡量一次更新是否有效,要看它在长期内是否降低有用信息的获取成本、提高可靠性,或改善边界判断。单独增加工具、记忆或 Agent 数量,不能保证这些改进。具体可以表现为:
两个 Agent 得到同样的正确答案,一个只做了必要的推理和一次验证,另一个却调用十几个工具,经历多轮无效循环,中途还可能执行高风险动作。只看成功率,两者得分相同;部署时还需要比较这些成本与风险。
论文把结果评测与过程评测结合起来,并讨论如何综合分析两者:
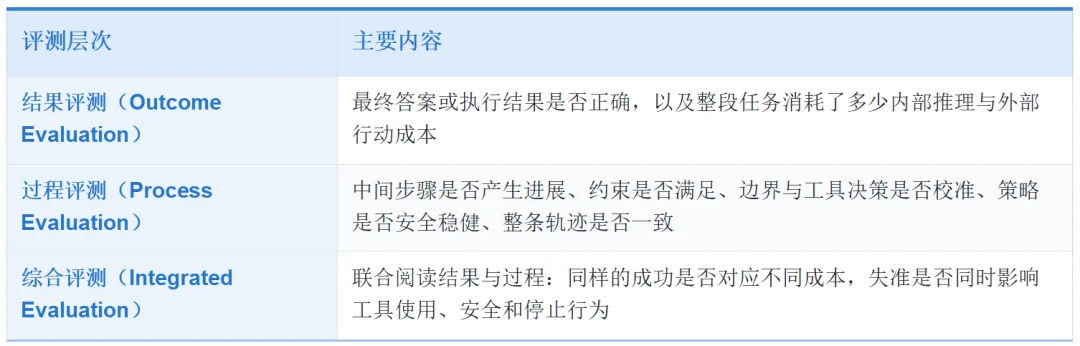
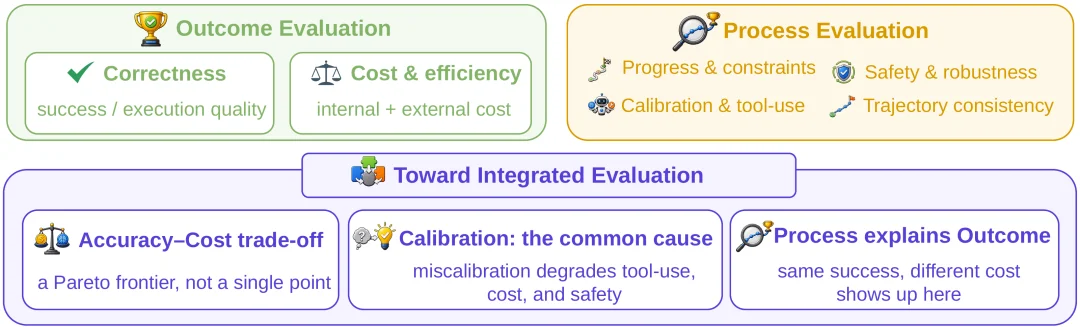
图 9:结果评测与过程评测的两类指标,以及成本与准确率权衡、边界校准和认知智能比率的联合分析方式。
准确率、内部成本、外部成本、安全、校准和过程质量需要分别报告,单一的排行榜分数无法呈现这些差异。只有具备充分的结果与轨迹观测,η 才适合作为统一分析视角。
怎样评测工具调用是否必要?
按 ToA 的视角,现有 Agent benchmark 可以分为三类:
1. 内化能力评测用于建立内部基线,覆盖知识、推理、动态更新的 live evaluation 和认知自我监测;
2. 外化能力评测考察 Agent 使用工具、Web/GUI/OS、软件仓库、研究环境,以及外部记忆、技能和 harness 的能力;
3. 权衡导向评测关注边界判断:需要外部支持时是否调用,不需要时是否能够克制调用。
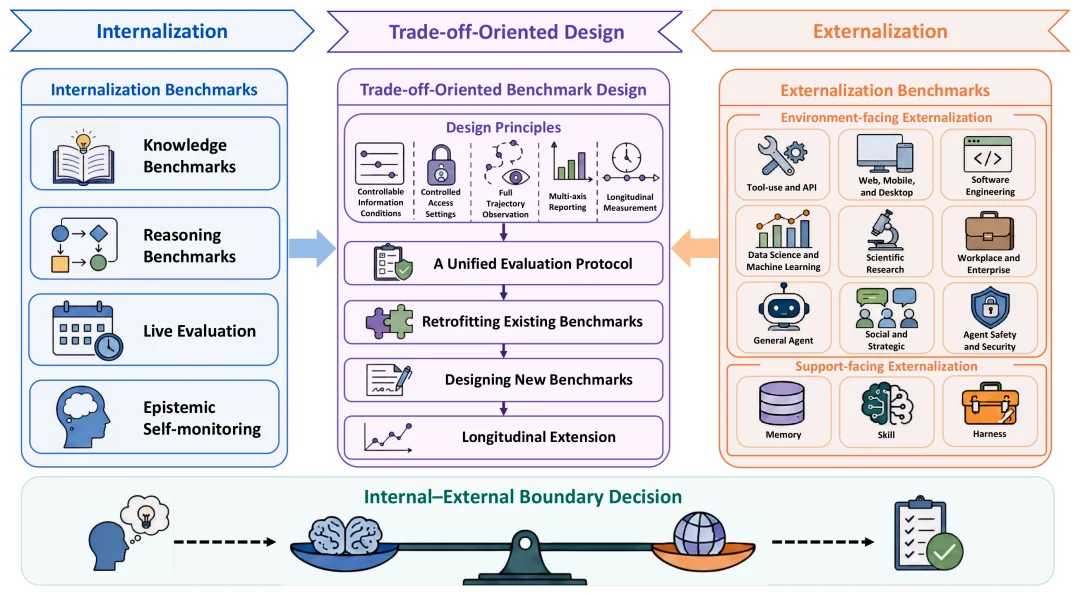
图 10:ToA 视角下的 benchmark 体系。内化评测给出模型内部基线,外化评测描述可用环境与支持系统,权衡导向设计直接测量内外边界决策。
论文给出的反事实评测协议,对同一道任务设置三种访问条件:
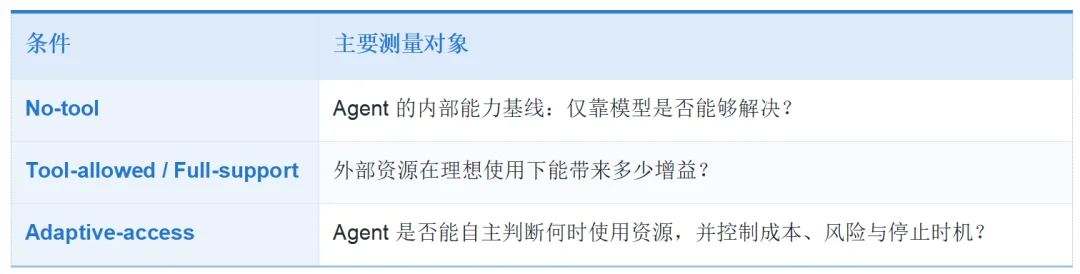
对照这些条件,可以检查以下边界决策:
论文还提出,下一代 benchmark 需要满足五项要求:
1. 可控的信息条件:明确决定性证据位于模型、上下文、记忆还是外部环境;
2. 可控的访问条件:对同一任务比较无工具、固定支持和自适应支持;
3. 完整轨迹观测:记录推理、检索、工具、验证、委派和停止等操作;
4. 多轴报告:同时报告成功、边界错误、内部与外部成本、安全和验证质量;
5. 纵向测量:观察 Agent 在积累经验后,是否减少冗余调用、改善停止决策,并将稳定能力选择性内化。
论文最后讨论了四个开放方向:
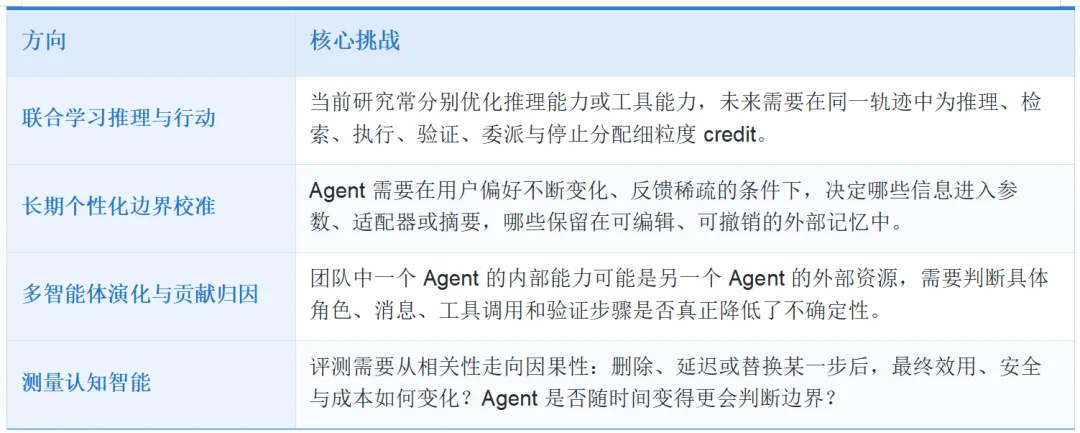
论文将内化与外化的边界作为 Agent 设计的治理轴,用它分析知识、技能与控制的位置,以及每一步推理和行动的投入。这些选择会影响系统的可靠性、效率、安全性和持续演化能力。
这套框架没有预设内化或外化的优先级。是否调用工具,要看任务是否需要;是否继续思考,要看剩余不确定性能否在内部消解。经验是否进入参数,外部记忆、技能和工作流是否继续留在 harness,也需要依据稳定性、复用价值和治理要求作出选择。
文章来自于"机器之心",作者 "机器之心"。


【开源免费】OWL是一个完全开源免费的通用智能体项目。它可以远程开Ubuntu容器、自动挂载数据、做规划、执行任务,堪称「云端超级打工人」而且做到了开源界GAIA性能天花板,达到了57.7%,超越Huggingface 提出的Open Deep Research 55.15%的表现。
项目地址:GitHub:https://github.com/camel-ai/owl
【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】字节工作流产品扣子两大核心业务:Coze Studio(扣子开发平台)和 Coze Loop(扣子罗盘)全面开源,而且采用的是 Apache 2.0 许可证,支持商用!
项目地址:https://github.com/coze-dev/coze-studio
【开源免费】n8n是一个可以自定义工作流的AI项目,它提供了200个工作节点来帮助用户实现工作流的编排。
项目地址:https://github.com/n8n-io/n8n
在线使用:https://n8n.io/(付费)
【开源免费】DB-GPT是一个AI原生数据应用开发框架,它提供开发多模型管理(SMMF)、Text2SQL效果优化、RAG框架以及优化、Multi-Agents框架协作、AWEL(智能体工作流编排)等多种技术能力,让围绕数据库构建大模型应用更简单、更方便。
项目地址:https://github.com/eosphoros-ai/DB-GPT?tab=readme-ov-file
【开源免费】VectorVein是一个不需要任何编程基础,任何人都能用的AI工作流编辑工具。你可以将复杂的工作分解成多个步骤,并通过VectorVein固定并让AI依次完成。VectorVein是字节coze的平替产品。
项目地址:https://github.com/AndersonBY/vector-vein?tab=readme-ov-file
在线使用:https://vectorvein.ai/(付费)
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】graphrag是微软推出的RAG项目,与传统的通过 RAG 方法使用向量相似性作为搜索技术不同,GraphRAG是使用知识图谱在推理复杂信息时大幅提高问答性能。
项目地址:https://github.com/microsoft/graphrag
【开源免费】Dify是最早一批实现RAG,Agent,模型管理等一站式AI开发的工具平台,并且项目方一直持续维护。其中在任务编排方面相对领先对手,可以帮助研发实现像字节扣子那样的功能。
项目地址:https://github.com/langgenius/dify
【开源免费】RAGFlow是和Dify类似的开源项目,该项目在大文件解析方面做的更出色,拓展编排方面相对弱一些。
项目地址:https://github.com/infiniflow/ragflow/tree/main
【开源免费】phidata是一个可以实现将数据转化成向量存储,并通过AI实现RAG功能的项目
项目地址:https://github.com/phidatahq/phidata
【开源免费】TaskingAI 是一个提供RAG,Agent,大模型管理等AI项目开发的工具平台,比LangChain更强大的中间件AI平台工具。
项目地址:https://github.com/TaskingAI/TaskingAI
