
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
刚刚,生数上线了最新的 实时视频模型 S2,输出提高到 720p,保持 25—42 FPS,包含下面两款:
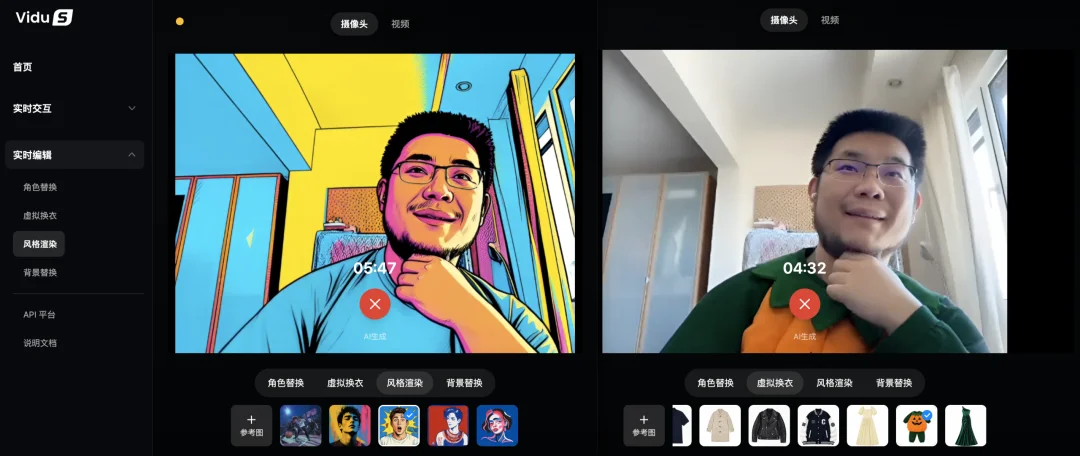
比如...左侧是风格转绘,右侧是给我换了身衣服
这东西现在已经可以玩了,这里体验:https://vidu.com/vidu-stream
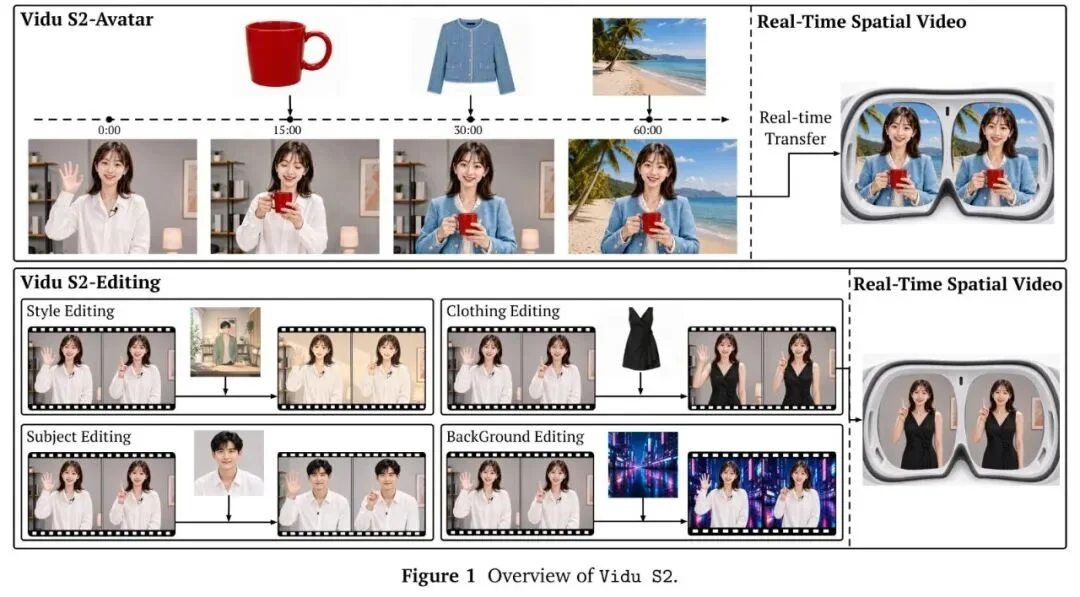
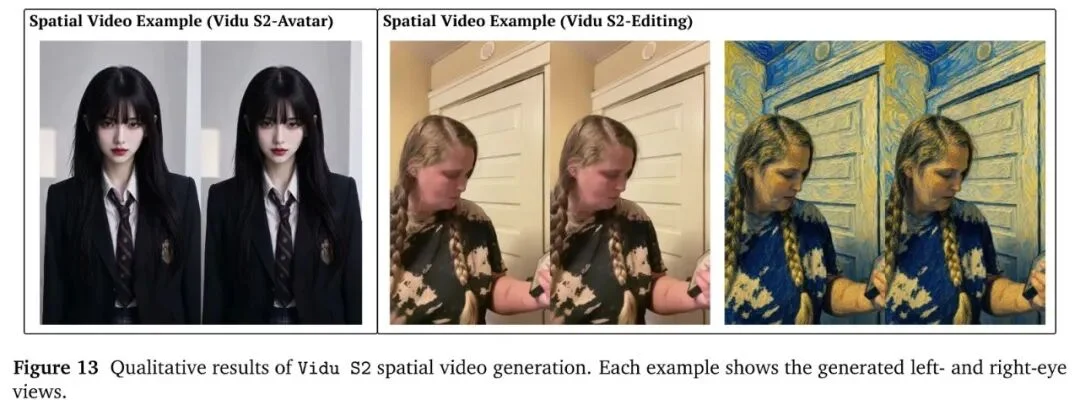
而在这两个模型之后,还有一个延伸发布:实时空间视频方案,可供头显使用,能将生成后的画面变成左右眼视图
这事儿,可以并着下面这个新闻来看,大家都在朝着「小扎未竟之路」来探索
Avatar 延续的是 S1 的路线,仅凭一张图,便可生成交互数字人。但 S2 做了一个很大的改进“动态参考”,你可以在对话的过程中,随时更改角色设定以及场景、衣物、道具
比如在对话的过程中,你可以随时给他一张杯子的图片,让它拿起来,或者给他一个外套的照片,让它换上
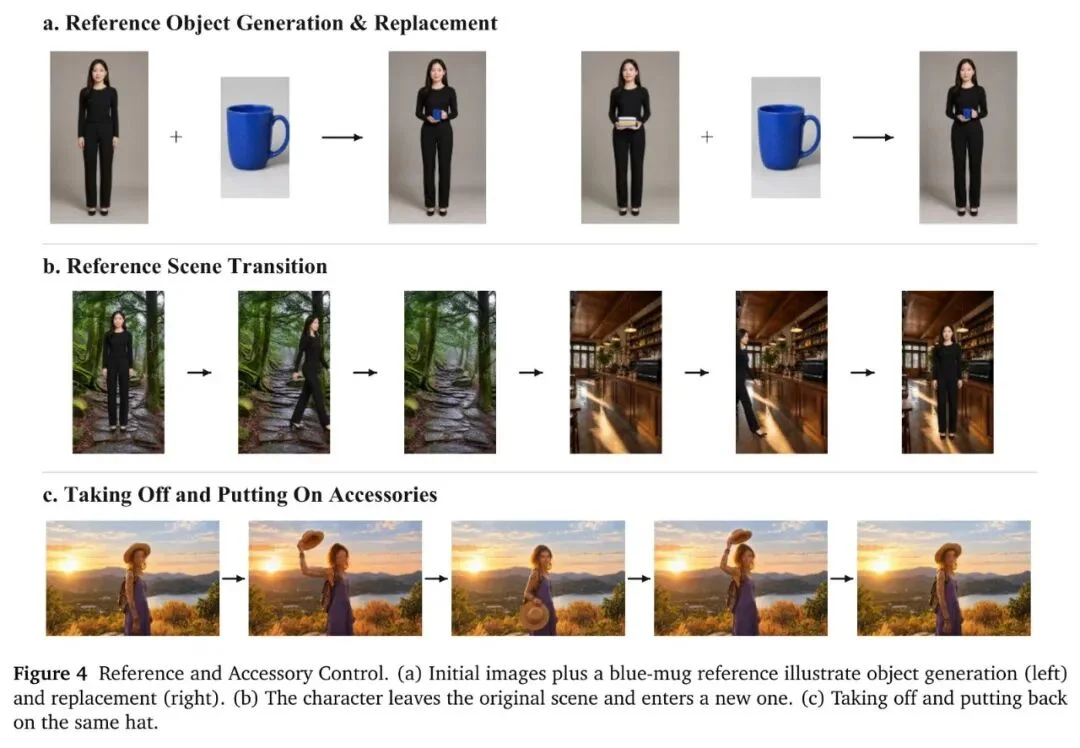
另外我去查看了 tech report,发现了一个有趣的细节,就是 Vidu 是如何保证角色行为的一致性的:他们做了一层 VLM Agent,用来生成后续 prompt举个例子,当让角色“拿起杯子,然后微笑”时,这个 Agent 会把后面的提示会明确保留“继续拿着杯子”,只改变表情,避免新指令把前面的状态覆盖掉
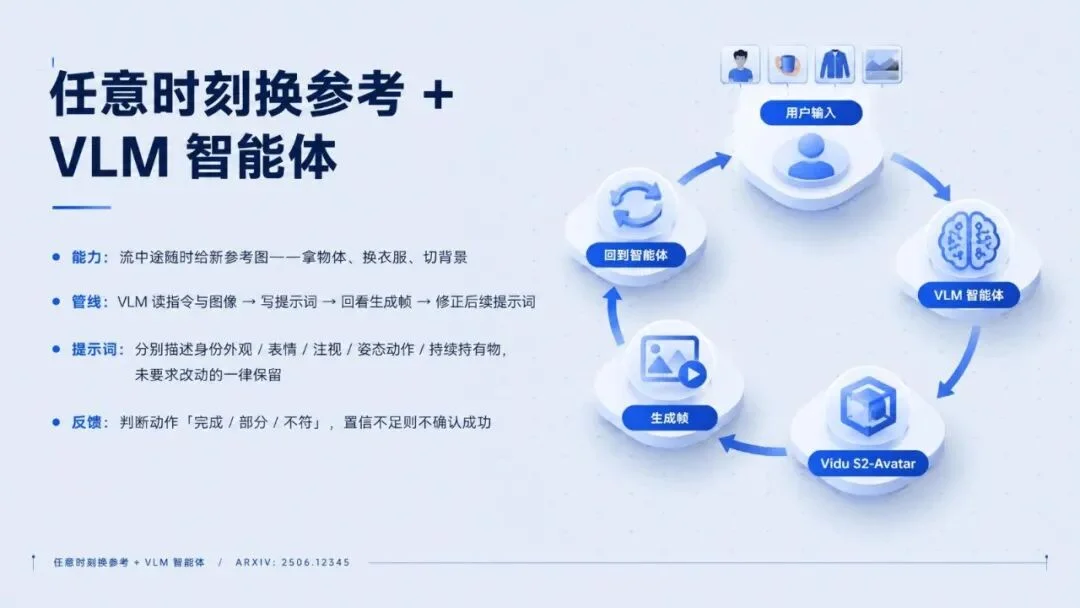
视频模型负责生成,Agent 负责维护状态
S2 在交付效果上做到了大幅提升。在训练的过程中,增加了独舞和 2D、3D 动画数据,指令跟随也扩展到更完整的身体动作。在画面渲染上采用低分辨率骨干加单步 Refiner,骨干侧偏重运动与时序,Refiner 侧保留外观细节。输出从 540p 提高到 720p,报告给出的速度是 25—42 FPS
为了长时间生成的稳定性,则用到了他们提出的 Self-Replay Forcing,简称 SRF,也就是模型先按实际推理方式生成一段长轨迹,再把自己生成的片段重新加噪,进行因果回放训练,用来改善连续生成中的误差累积
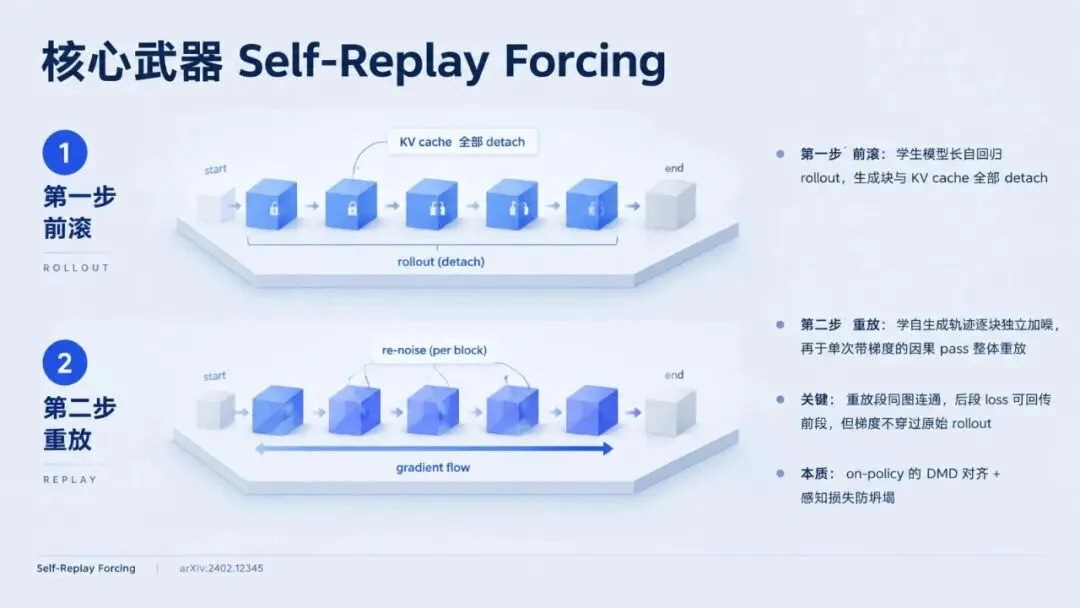
Editing 则是直接接收视频流,根据文字指令和可选参考图,实时换画风与内容。和 Avatar 不同,这里的动作由原视频提供,也就是用来「P 视频」的
比如你在摄像头前做手势舞,这时候给他上传一张牛来,就可以让输出画面里的牛来去跳了,它目前支持四类任务:风格迁移、虚拟试穿、人物替换、背景替换
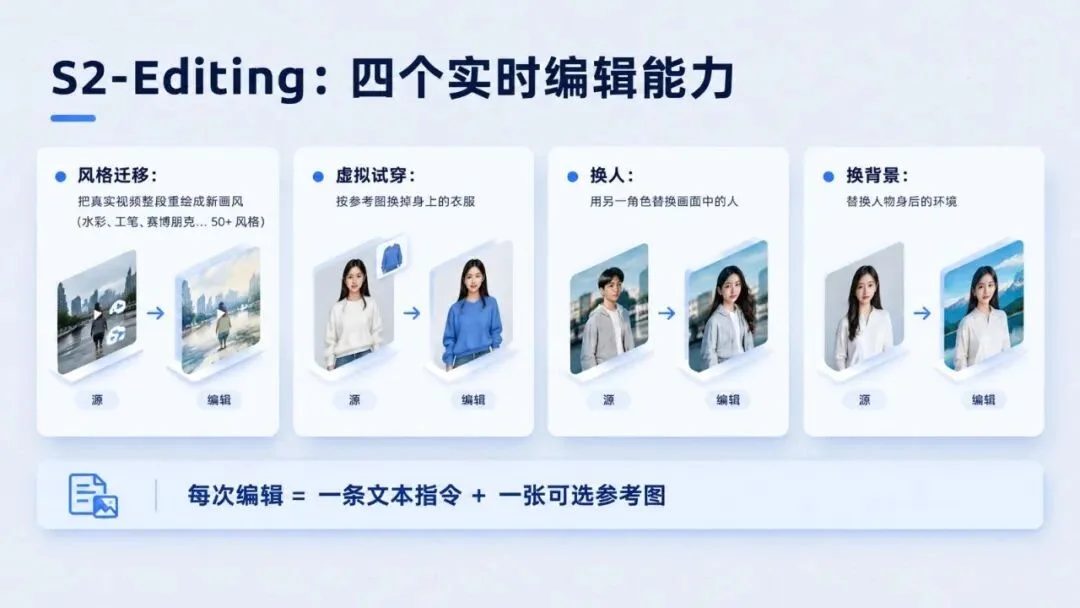
下面的这些案例来自 tech report
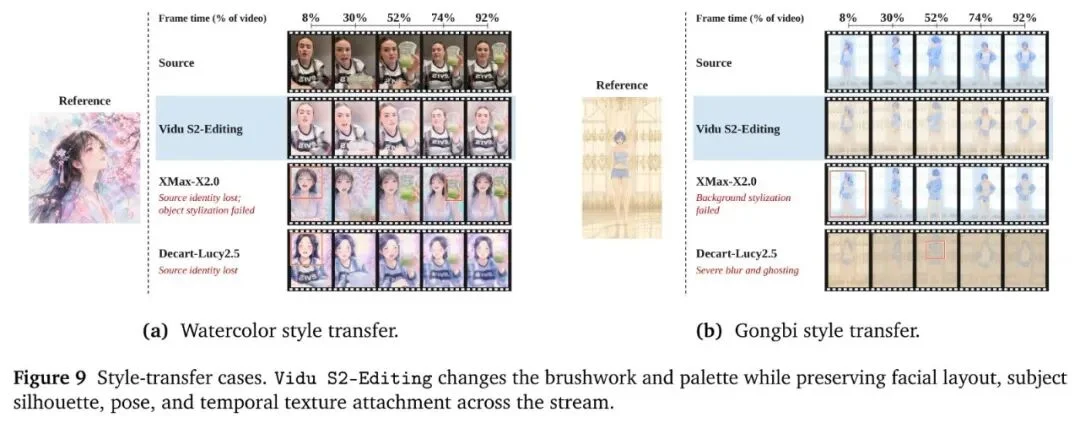
风格迁移:水彩与工笔风格
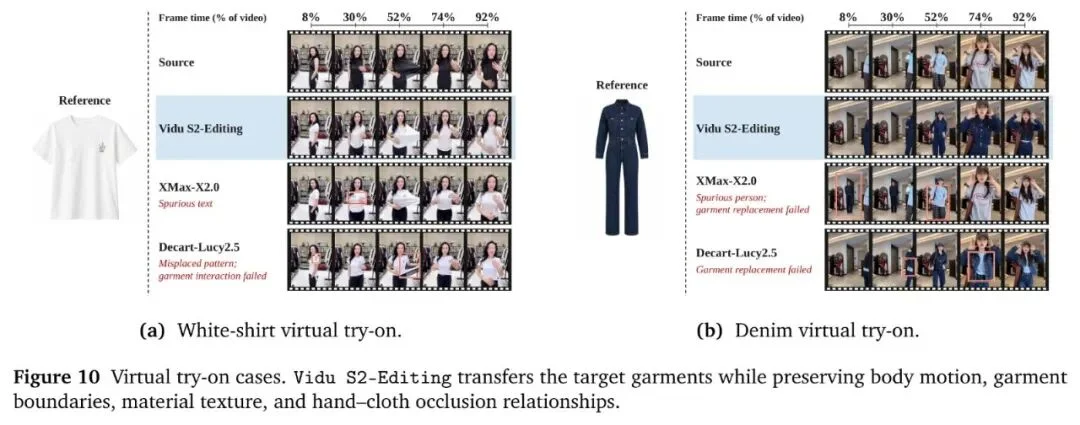
虚拟试穿:白衬衫与牛仔服
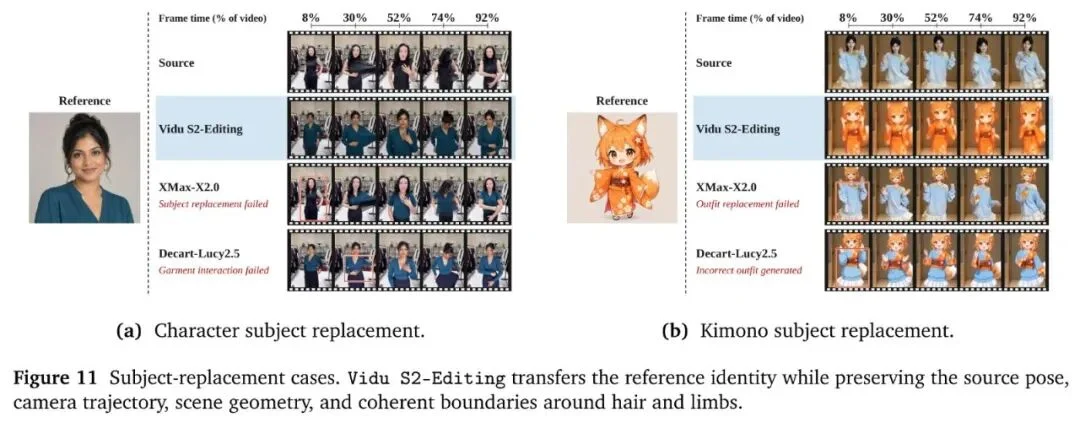
角色替换:真人与卡通角色
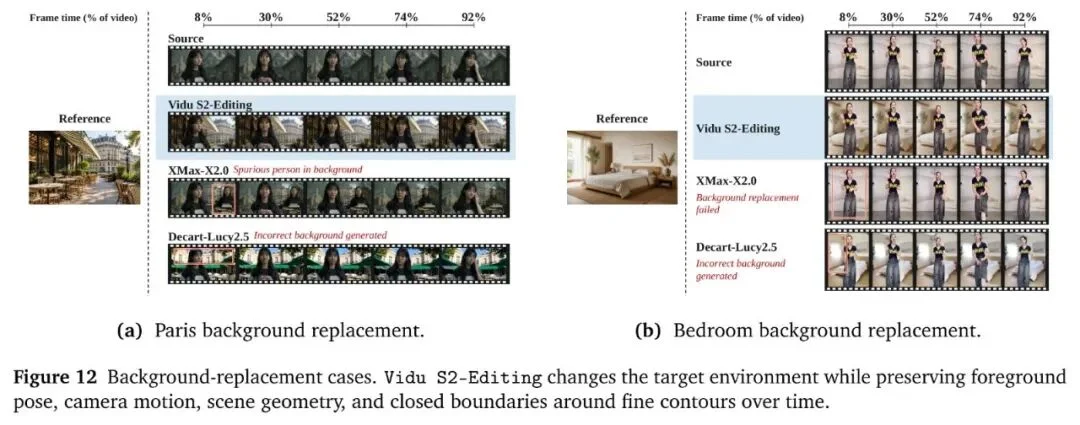
背景替换:巴黎街景与卧室
这个技术有个难点:如何让改动的画面不穿模比如在拉扯衬衫的时候,如果我把衬衫换成了别的衣服,那也意味着衣服上的花纹、质感什么的也都会变好,而模型要同时理解参考图里的衣服特征,也要保留原视频里人与衣服的互动
对此,Vidu 团队使用了 Frame-Aligned Attention 的解法,也就是目标帧在读取源视频时,只与同一时刻的源帧交换信息;参考图则可以被各个目标帧读取,持续提供新的外观条件,避免把不同时间点的源画面混在一起。进入流式生成后,模型仍会结合有效的历史片段继续输出。
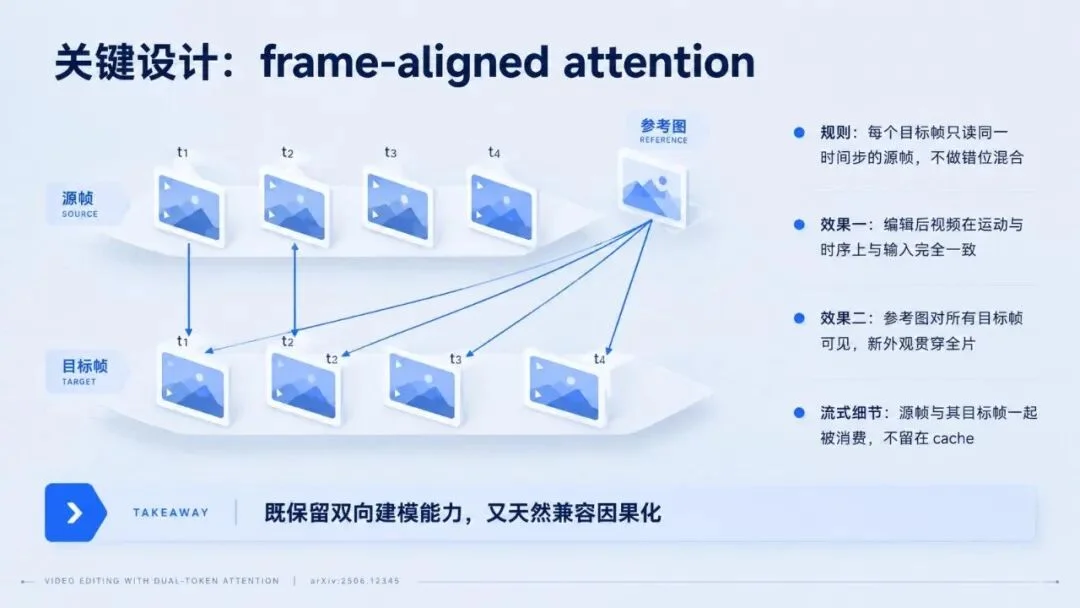
训练上,Editing 也复用了前面的因果流式方案和 SRF,用来改善连续编辑中的一致性,并进行了特别的内存优化,降低整条流程的延迟
Vidu 在前面两个模型的基础上,继续往后做了一步,为左右眼提供略有差异的画面,做到「实时空间视频」
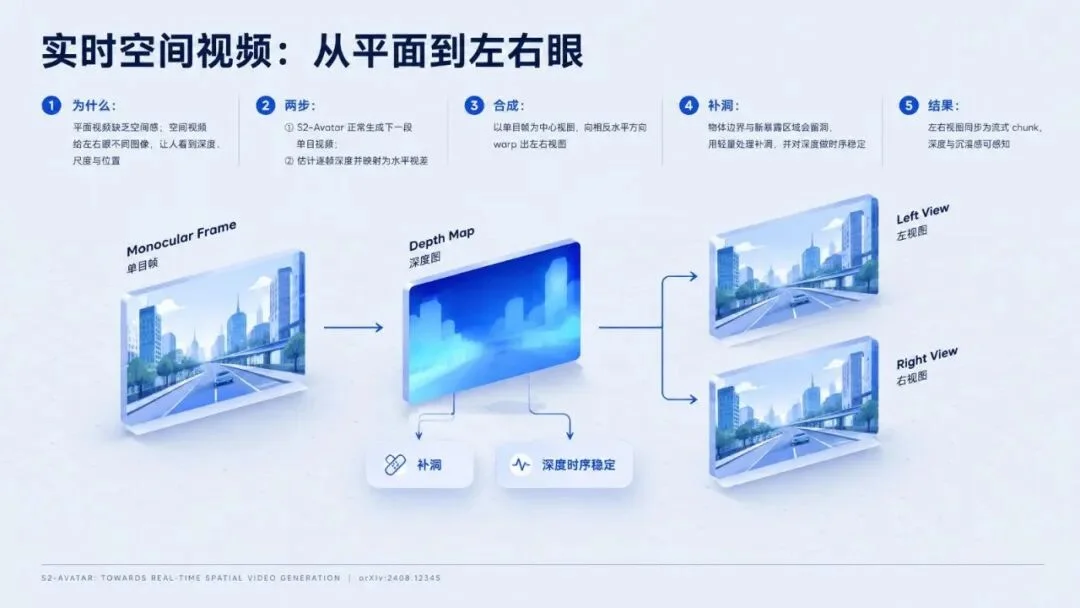
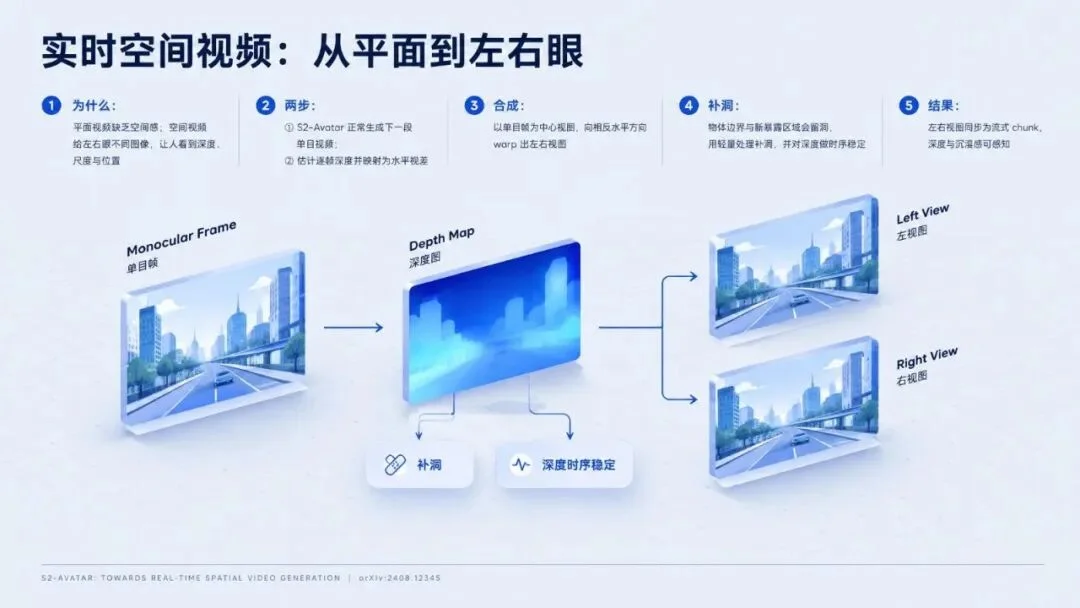
在这个过程中,会先生成普通视频,再根据深度生成左右眼视图,持续送给头显;单目画面,转换成左右眼视图
如果是实时编辑视频的话,就分为两种情况:
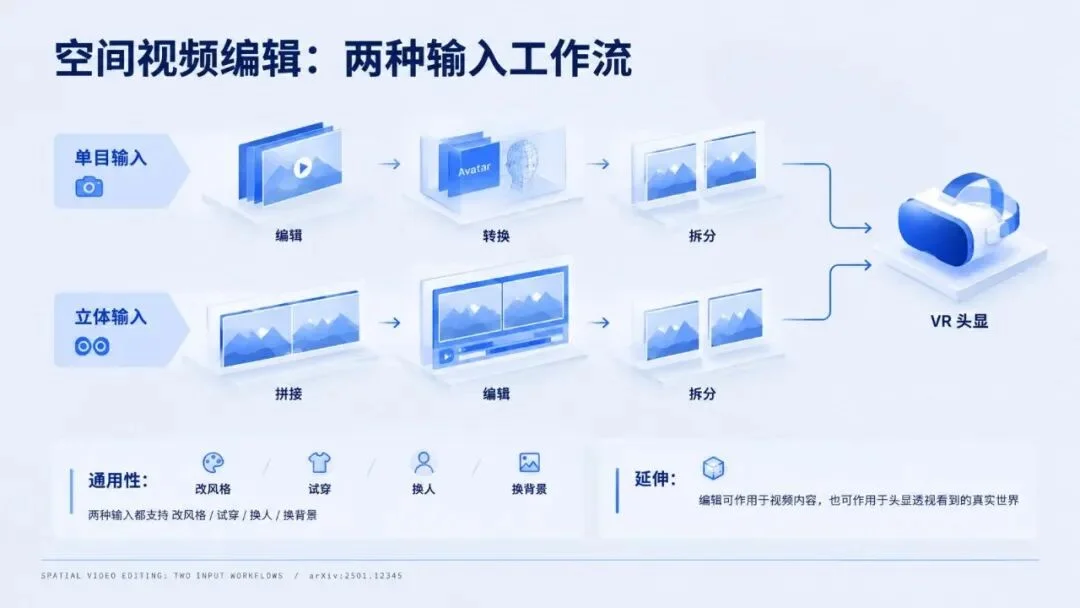
根据官方说法,基于 BenchMark 评估,Vidu S2 模型做到了领域 Sota
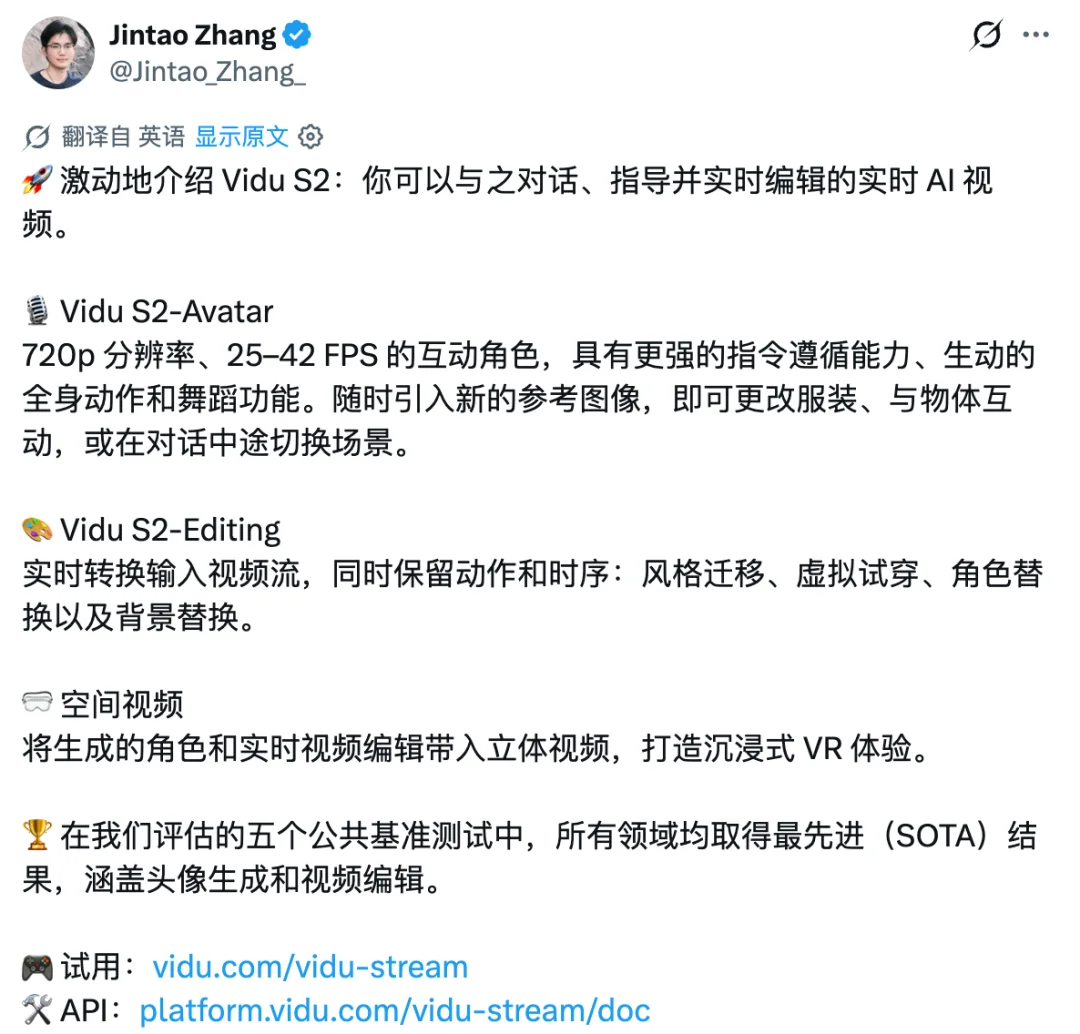
Vidu S2 的全链路研发由朱军教授的博士生张金涛负责,他也是生数科技流式视频生成与推理负责人
这里的 BenchMark 包含对应 Avatar 的 StreamAV-Bench,以及 Editing 的 Sparkle-Bench、OpenVE、RefVIE 和 ViViD 试穿测试集,摘取如下
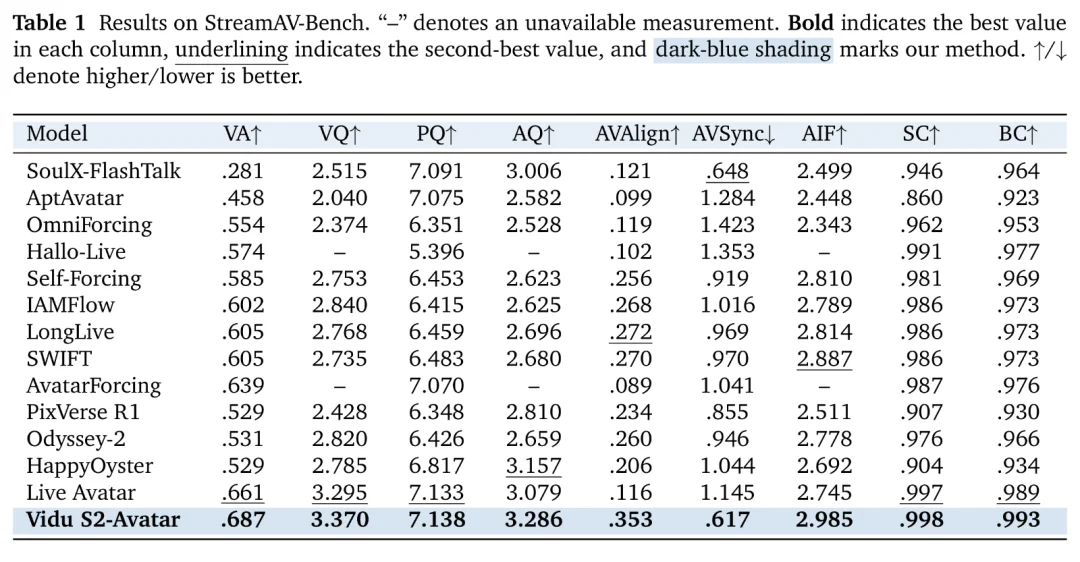
StreamAV-Bench
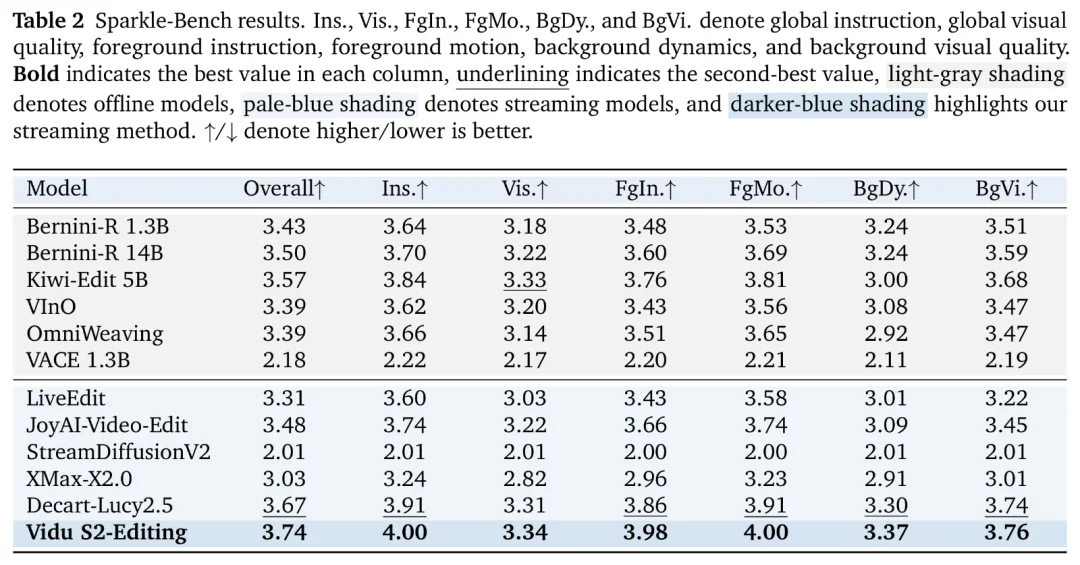
Sparkle-Bench
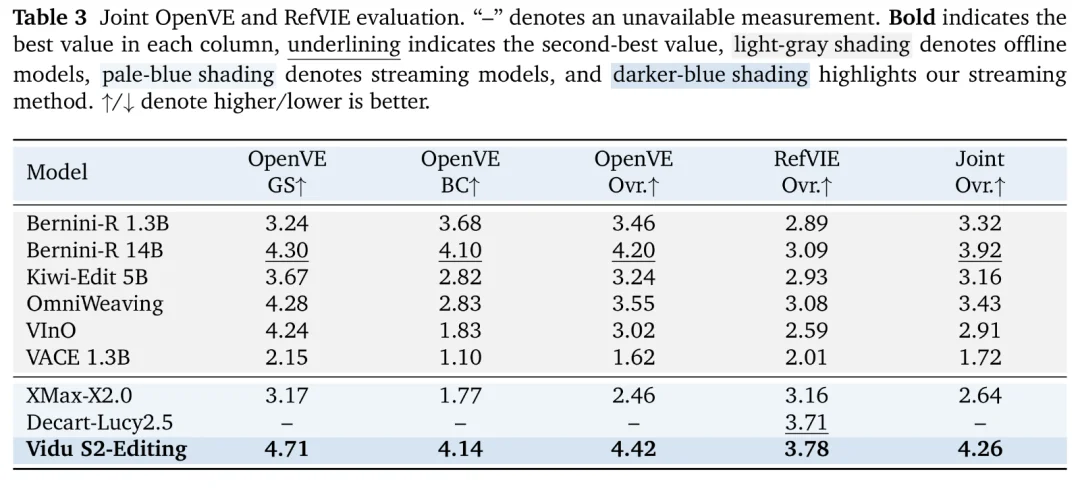
OpenVE 与 RefVIE
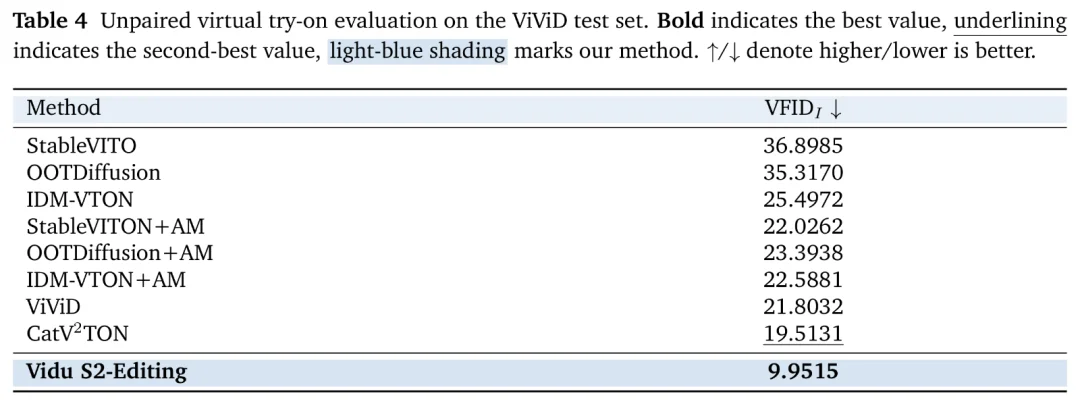
ViViD 虚拟试穿
产品今天已经通过 Vidu 的官网,以在线 Demo 和 API 的方式放出,可以来试一个有关技术报告在这里,感兴趣的可以阅读技术报告:https://arxiv.org/pdf/2609.11638
文章来自于"赛博禅心",作者 "金色传说大聪明"。


【开源免费】Fay开源数字人框架是一个AI数字人项目,该项目可以帮你实现“线上线下的数字人销售员”,
“一个人机交互的数字人助理”或者是一个一个可以自主决策、主动联系管理员的智能体数字人。
项目地址:https://github.com/xszyou/Fay
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0
【开源免费】VideoChat是一个开源数字人实时对话,该项目支持支持语音输入和实时对话,数字人形象可自定义等功能,首次对话延迟低至3s。
项目地址:https://github.com/Henry-23/VideoChat
在线体验:https://www.modelscope.cn/studios/AI-ModelScope/video_chat
【开源免费】Streamer-Sales 销冠是一个AI直播卖货大模型。该模型具备AI生成直播文案,生成数字人形象进行直播,并通过RAG技术对现有数据进行寻找后实时回答用户问题等AI直播卖货的所有功能。
项目地址:https://github.com/PeterH0323/Streamer-Sales
